2026 年 11 月 7 日,上海,人工智能训练师(二级)专项职业技能大赛。从拿到第一份官方文件到走进考场,实际可用时间 4 天。最后通过了。
这篇不是"AI 帮我学习"的感想,而是一次工程复盘:我把备考当成一个有明确交付物、有迭代节奏、有验收标准的内部项目,AI 在里面扮演的不是答疑老师,而是「能读完 300 页 PDF、能写代码、能跨会话记住决策」的工程搭档。
0. 一句话结论
备考的瓶颈通常不是"学不懂",而是三件事:不知道考什么、记不住、练不完。
这三件事都有工程解:
- 「不知道考什么」→ 把原始 PDF 逐页转成结构化事实,算清权重漂移;
- 「记不住」→ 把知识压缩成可打印、可出声念的骨架,而不是再读一遍教材;
- 「练不完」→ 做一个带错题闭环和限时引擎的本地系统,让每次练习都留下数据。
AI 在这三件事上的价值都是"完成度"而不是"聪明":它愿意把 34 页样卷逐页数题,愿意为一个中文对齐问题写 20 行函数,愿意在第四次改同一张表时仍然记得第一次为什么这么定。
1. 背景与约束
先交代牌面,因为没有约束就没有设计。
| 项 | 实际情况 |
|---|---|
| 考试结构 | A 理论 100 分 / 90 min,B 技能 100 分 / 120 min,C 综合评审 100 分 / 30 min |
| 考试顺序 | B(13:00–15:00) → C(15:00–15:30) → A(15:30–17:00),与"先理论后实操"的常识相反 |
| 通过机制 | 按排名取前 50%,不是 60 分及格线(往年最高分不到 60) |
| 可用时间 | 10/30 拿到样卷 → 11/07 开赛,扣除工作,实际投入约 4 个完整天 |
| 参考资料 | 官方样卷 34 页、评分框架、赛务文件、预习练习册 58 页、参考答案 44 页、7 份真实答卷、5 次培训纪要 |
| 我的短板 | 实操题里 B1.2 / B2 要写 Python,且是填空式(题目给骨架,挖掉关键行) |
其中「考试顺序」和「通过机制」这两条,是后面所有计划设计的支点。它们不是常识能推出来的,只能从赛务文件里读出来。
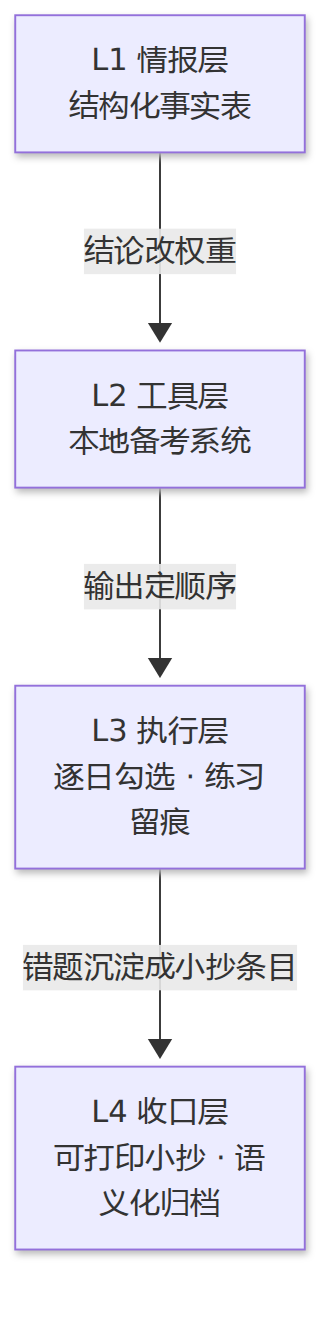
2. 总体思路:四层递进
我不把它做成"一个学习网站",而是分成四层,每层有独立交付物和验收标准。
| 层 | 产出 | 验收标准 | 时间 |
|---|---|---|---|
| L1 情报层 | 一份结构化事实表(考什么、多少分、什么顺序、哪些模块在涨) | 每条结论都能指回原文页码 | 10/30–11/02 |
| L2 工具层 | 本地备考系统(题库 / 错题 / 计划 / 小抄 / 存档) | 每个功能对应一次真实的使用失败 | 10/30–11/06 |
| L3 执行层 | 按计划表逐日勾选,所有练习留痕 | 存档文件能证明做过什么 | 11/02–11/07 |
| L4 收口层 | 可打印小抄 + 资料语义化归档 | 考前 12 小时只做减法 | 11/05–11/06 |
关键在于层与层之间有数据流:L1 的结论直接改 L2 的权重(不是拍脑袋排序),L2 的输出决定 L3 的顺序,L3 的错题沉淀成 L4 的小抄条目。
3. L1 情报层:把 PDF 变成可查询的事实
3.1 第一步不是读书,是清点
原始目录里散着 20 多个文件:压缩包、重复解压的素材、空文档、~$ 锁文件、PDF 和它的 docx 源文件。
我先让 AI 做了一次 MD5 级别的清点:两个素材 zip 与已解压目录 MD5 全等(纯重复)、参考答案的 docx 和 PDF 同源、还有一个 10240 字节的空 Word 文档混在里面。
这一步花 20 分钟,省掉后面反复"这个文件到底是不是最新的"的犹豫。在信息不干净的情况下谈复习计划,是自欺欺人。
3.2 逐页统计题量,发现了最大的一个坑
这份考试 2026 年是改版年。如果按 2025 真题的模块权重复习,会白做至少一半功。
我让 AI 把 2026 样卷 34 页逐页数题,得到真实分布:
| 模块 | 2025 | 2026 | 变化 |
|---|---|---|---|
| A6 产品与用户 | 9 题 11.7% | 17 题 22.1% | 升为第一权重 |
| A5 数据分析 | 4 题 5.2% | 12 题 15.6% | 涨 3 倍 |
| A7 项目管理 | 12 题 15.6% | 0 题 | 客观题全砍(B3 仍考) |
| A10 培训与指导 | 10 题 13% | 0 题 | 只保留 B4 实操 |
同时发现一处口径矛盾:评分框架写的是 100 分制配额,而样卷每题标注合计只有 42 分——这两套数字对不上,因为样卷是抽样卷。所以权重一律按「样卷题量占比」判定,不按分数绝对值。这条判断直接决定了后面星级体系的分布。
这件事人很难做——不是难在技术上,而是难在"愿意逐页数 34 页"。
3.3 八条硬情报
从赛务文件里还提取出直接影响策略的事实:连考 4 小时不换场、12:20 报到迟到 15 分钟按弃权、开赛 180 分钟后才可离场、每模块 3 位执裁专家打分等。其中第 2 条(顺序 B → C → A)改变了复习顺序,第 7 条(及格按排名前 50%)改变了心态——不是"考 60 分",是"别掉到后一半"。情报的价值不在于知道,而在于它改变了你做什么。
4. L2 工具层:11 个版本、7700 行代码是怎么长出来的
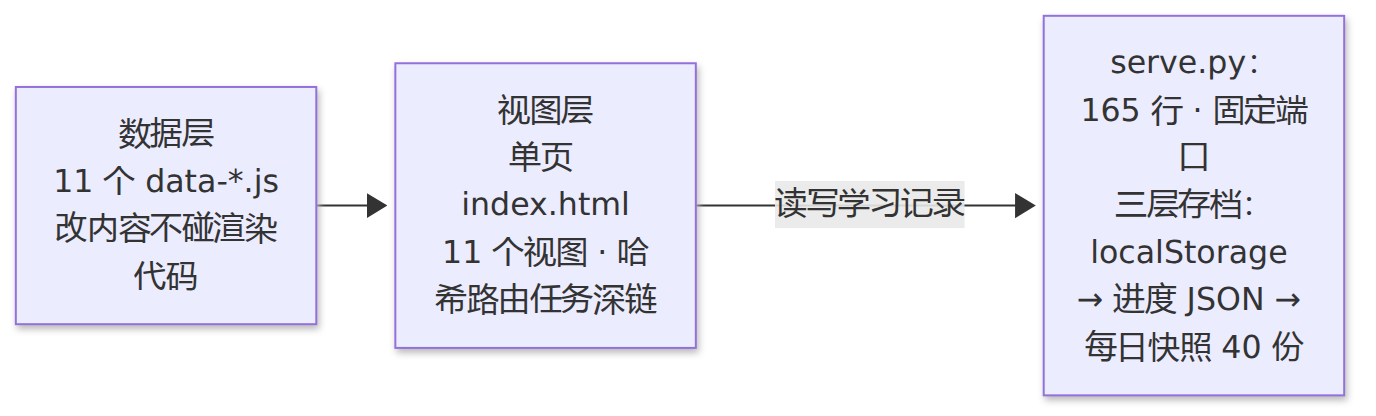
4.1 架构选型:为什么是"单页 + 数据文件"
| 选择 | 理由 |
|---|---|
单文件 index.html + assets/ | 零构建、零依赖,双击就能开;中文路径和空格不炸 |
数据与视图彻底分离(11 个 data-*.js) | 改内容不碰渲染代码,改一次不用重测全站 |
哈希路由 #case/B2 | 计划表里的任务能直接深链到对应页面 |
一个 165 行的 serve.py | 只为解决"存档丢失",不做框架 |
最终规模约 7,700 行:渲染逻辑最大,11 个数据文件合计占一半——数据比代码多,正是这个选型的结果。
4.2 版本演进:每个版本都由一次具体的失败触发
这是这份复盘里我最想强调的部分——功能不是设计出来的,是被问题挤出来的。
| 版本 | 触发的问题 | 主要新增 |
|---|---|---|
| v1 | 只有原始 PDF,不知道从哪看起 | 10 模块 103 知识点(四段式)、154 题题库、6 个实操模板、12 道简答骨架、7 天 35 项计划 |
| v2 | 赛务文件发布,发现顺序是 B→C→A | 「赛务要点」视图、倒计时锁定 13:00、计划重排为 6 天 29 项 |
| v3 | 题目不分轻重,做完就忘 | 星级体系、70 道定向强化题(共 224)、强化训练 / 简答训练 / 错题集三个新视图 |
| v4 | 书太厚,考前没时间重读 | 小抄速览:10 张速背卡,知识点压成 38 个块 |
| v5 | 代码块分不清"题目给的"和"我要写的" | 代码填空标注、纯内联 SVG 流程图 3 张 |
| v6 | 点"打印"出来是白页 | 独立 A4 打印版,8 页双色 |
| v7 | 换浏览器打开,做题记录全没了 | serve.py + 磁盘存档 + 每日快照 |
| v8 | 模块权重像 2025 口径 | 按 2026 样卷重算题量、知识点页加「2026 真题坐标」 |
| v9 | 资料散落、重复、路径过时 | 语义化归档成 7 个顶层目录 |
| v10 | 错题看完解析还是不知道为什么错 | 题目精读层:来源反解 + 题干双色标注 + 答题思路 |
| v11 | 最后要背的是骨架,不是题 | 「草稿纸骨架」视图 + 小抄扩到 15 页附页 |
4.3 几个真正提升效率的功能设计
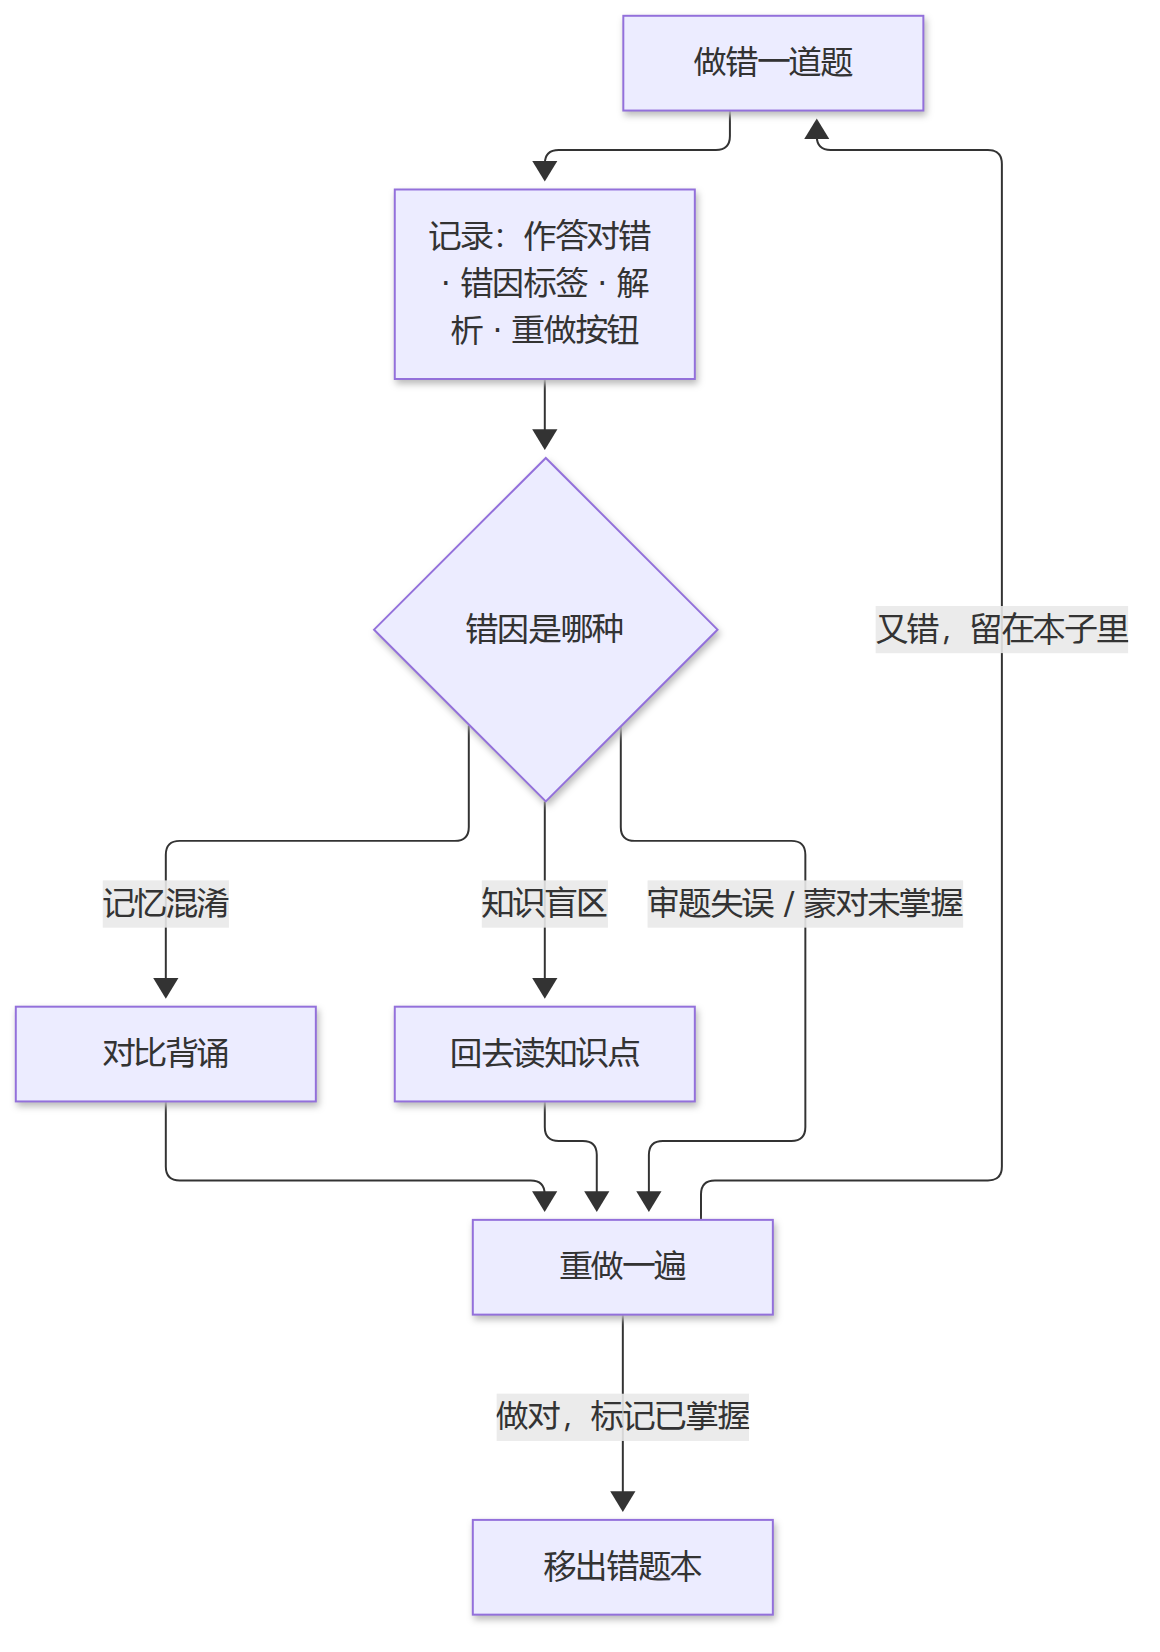
① 错题集:不是"收藏错题",是"记录你错的方式"
普通错题本只存正确答案,用处有限。我设计的是四件事同时记录:你的作答(红)vs 正确答案(绿)、错因标签四选一(知识盲区 / 审题失误 / 记忆混淆 / 蒙对未掌握)、重做按钮、标记已掌握才移出列表。
这个设计的用意是:记忆混淆和知识盲区需要完全不同的补救动作。前者靠对比背诵,后者靠回去读知识点。混在一起就变成了"又有错题,重做一遍",效率极低。最终存档里留下 19 道错题、19 条已掌握——错题是流动的,不是越积越多。
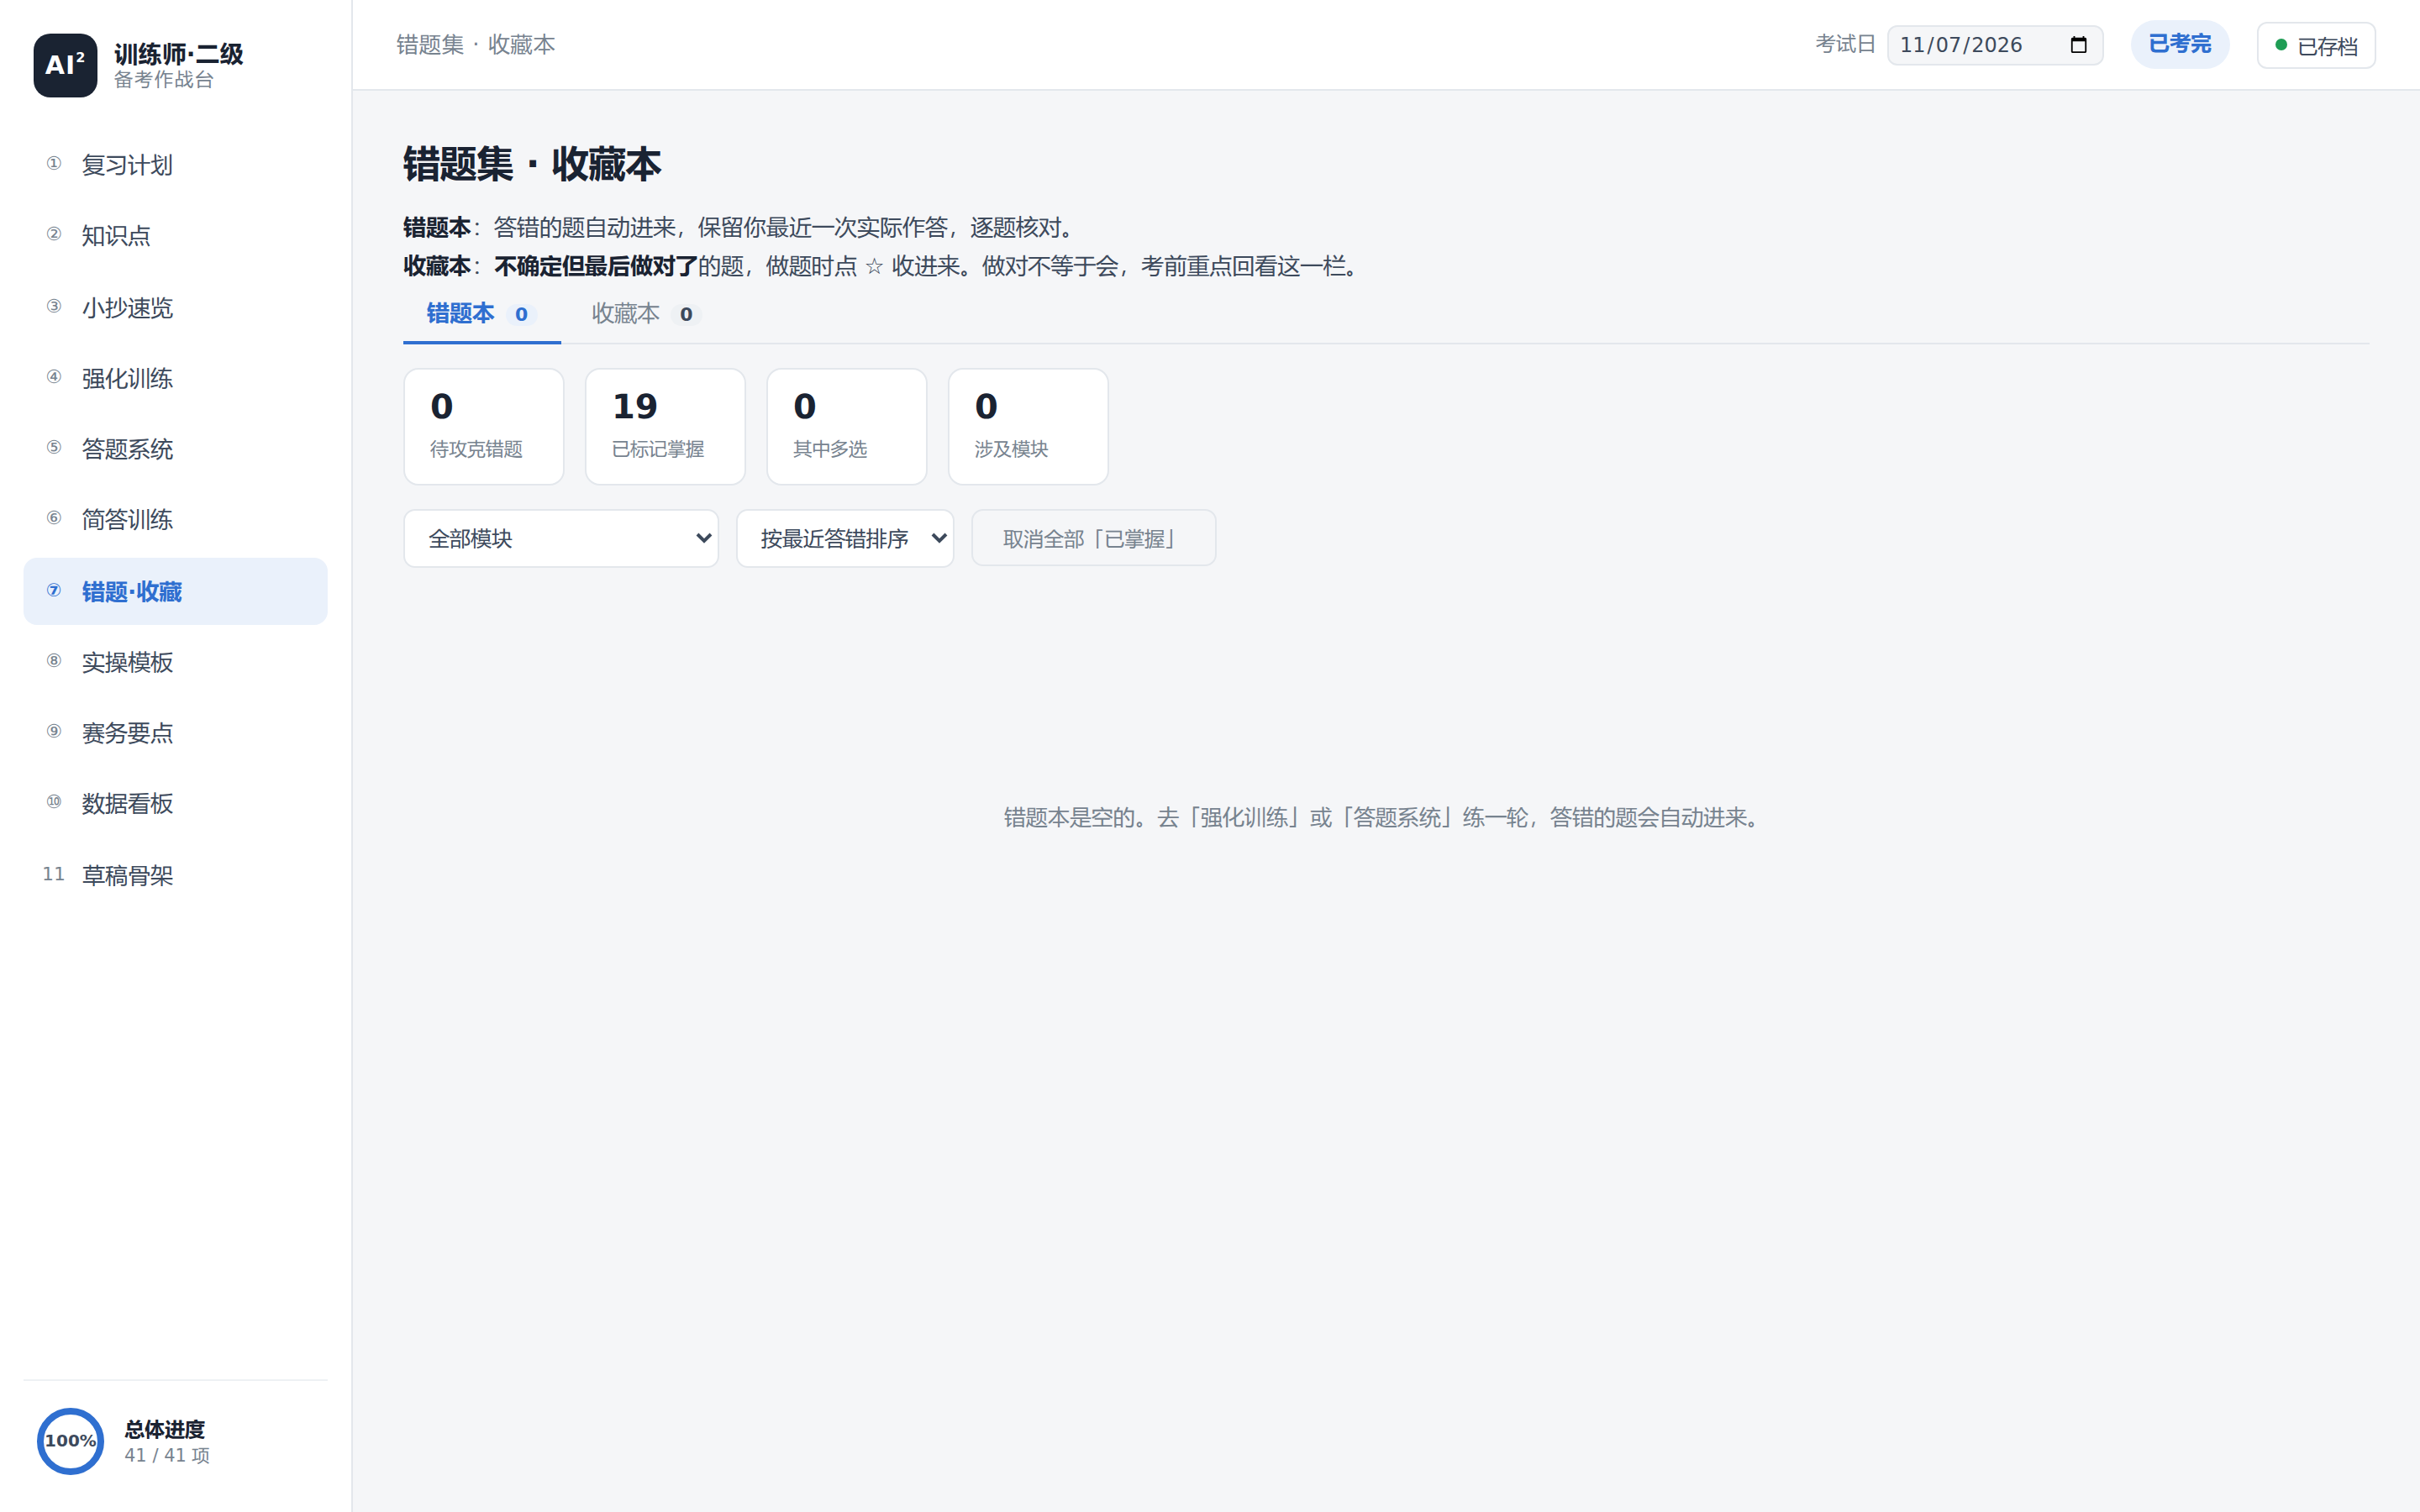
▲ 错题本终态:19 道错题全部标记已掌握,列表清零。
② 计划表:任务本身就是导航
计划表最容易做成"打勾清单",价值有限。我让每条任务带一个视图字段,点这条任务,页面直接跳到对应视图——比如点「【背骨架】小抄附页 1–3」就直达「草稿纸骨架」页。计划从"提醒你做"变成"送你去",启动成本从"打开页面、想一下在哪"降到"点一下",计划完成率明显不同。
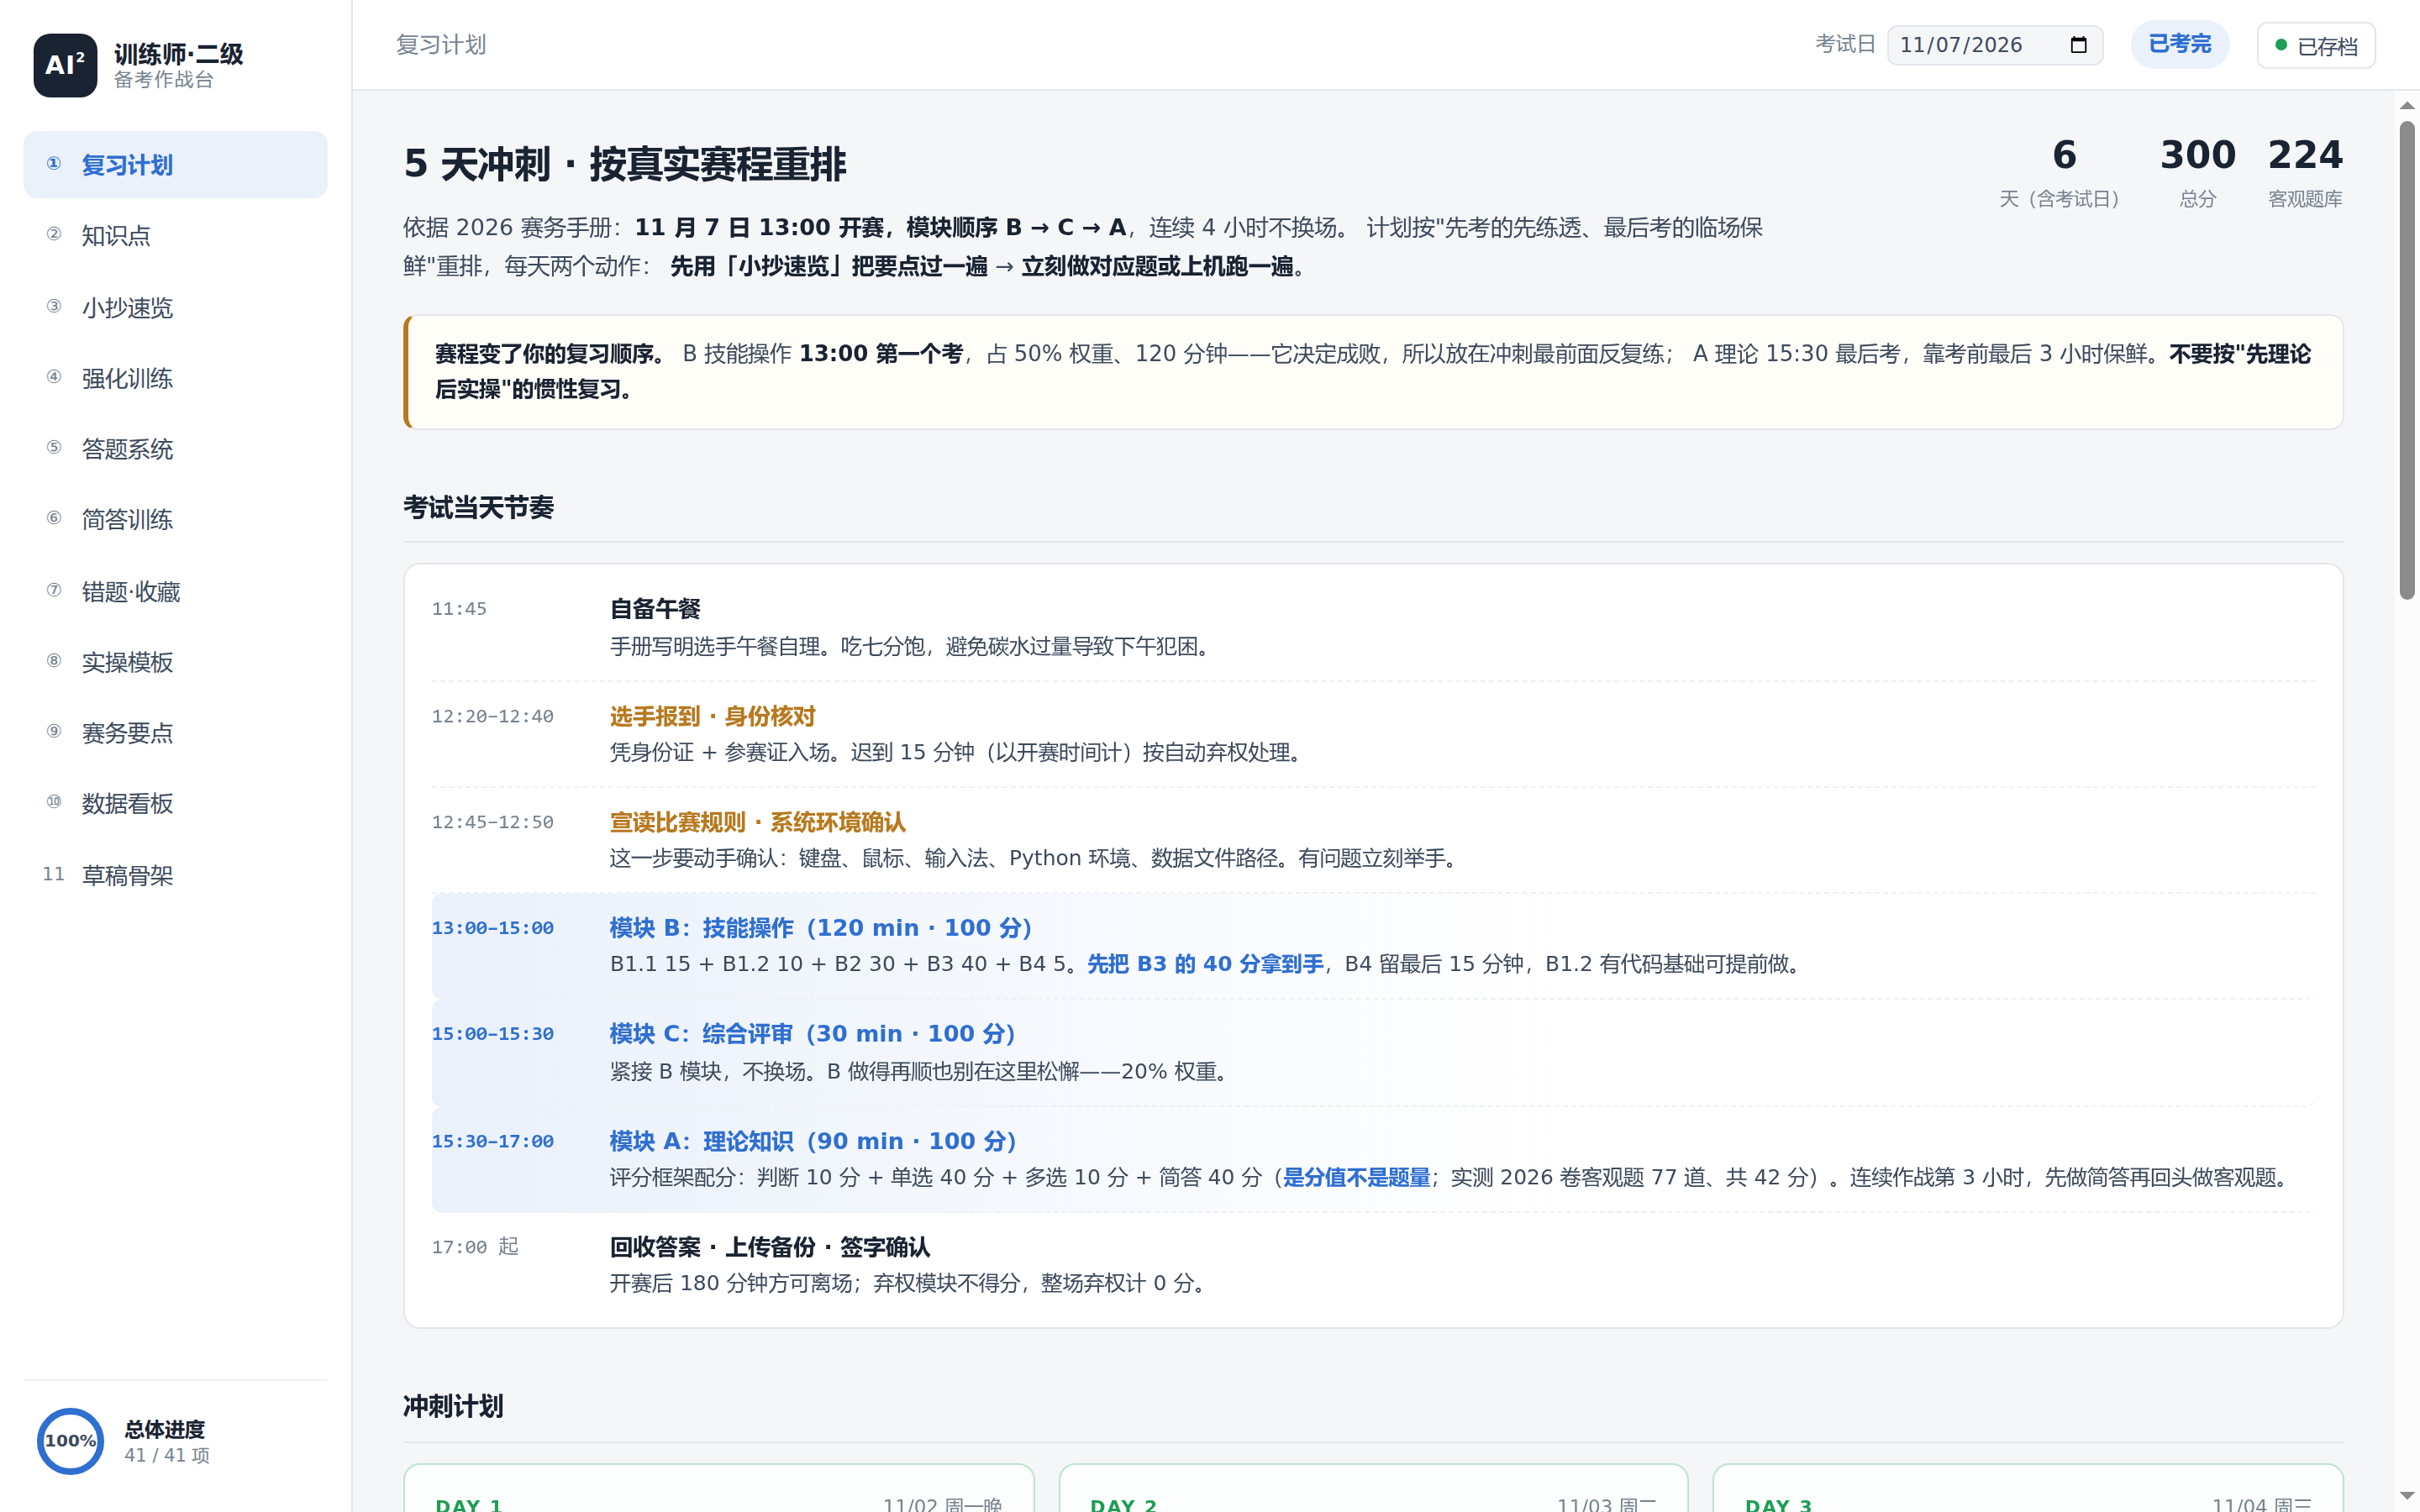
▲ 复习计划视图:每条任务带视图标签,点击直达对应页面。
③ 知识点页:每个模块能下钻到具体哪道题
知识点最怕"读着都懂,做题全错"。每个知识点模块下面挂一个可折叠的「2026 真题坐标」:命中题数一目了然,展开就是原始题干和解析。零题的模块(A7、A10)不折叠,直接显示黄色预警:「2026 零客观题,2025 考了 12 题,策略是不深挖不出错」。
这条预警省下的是最贵的资源:注意力。
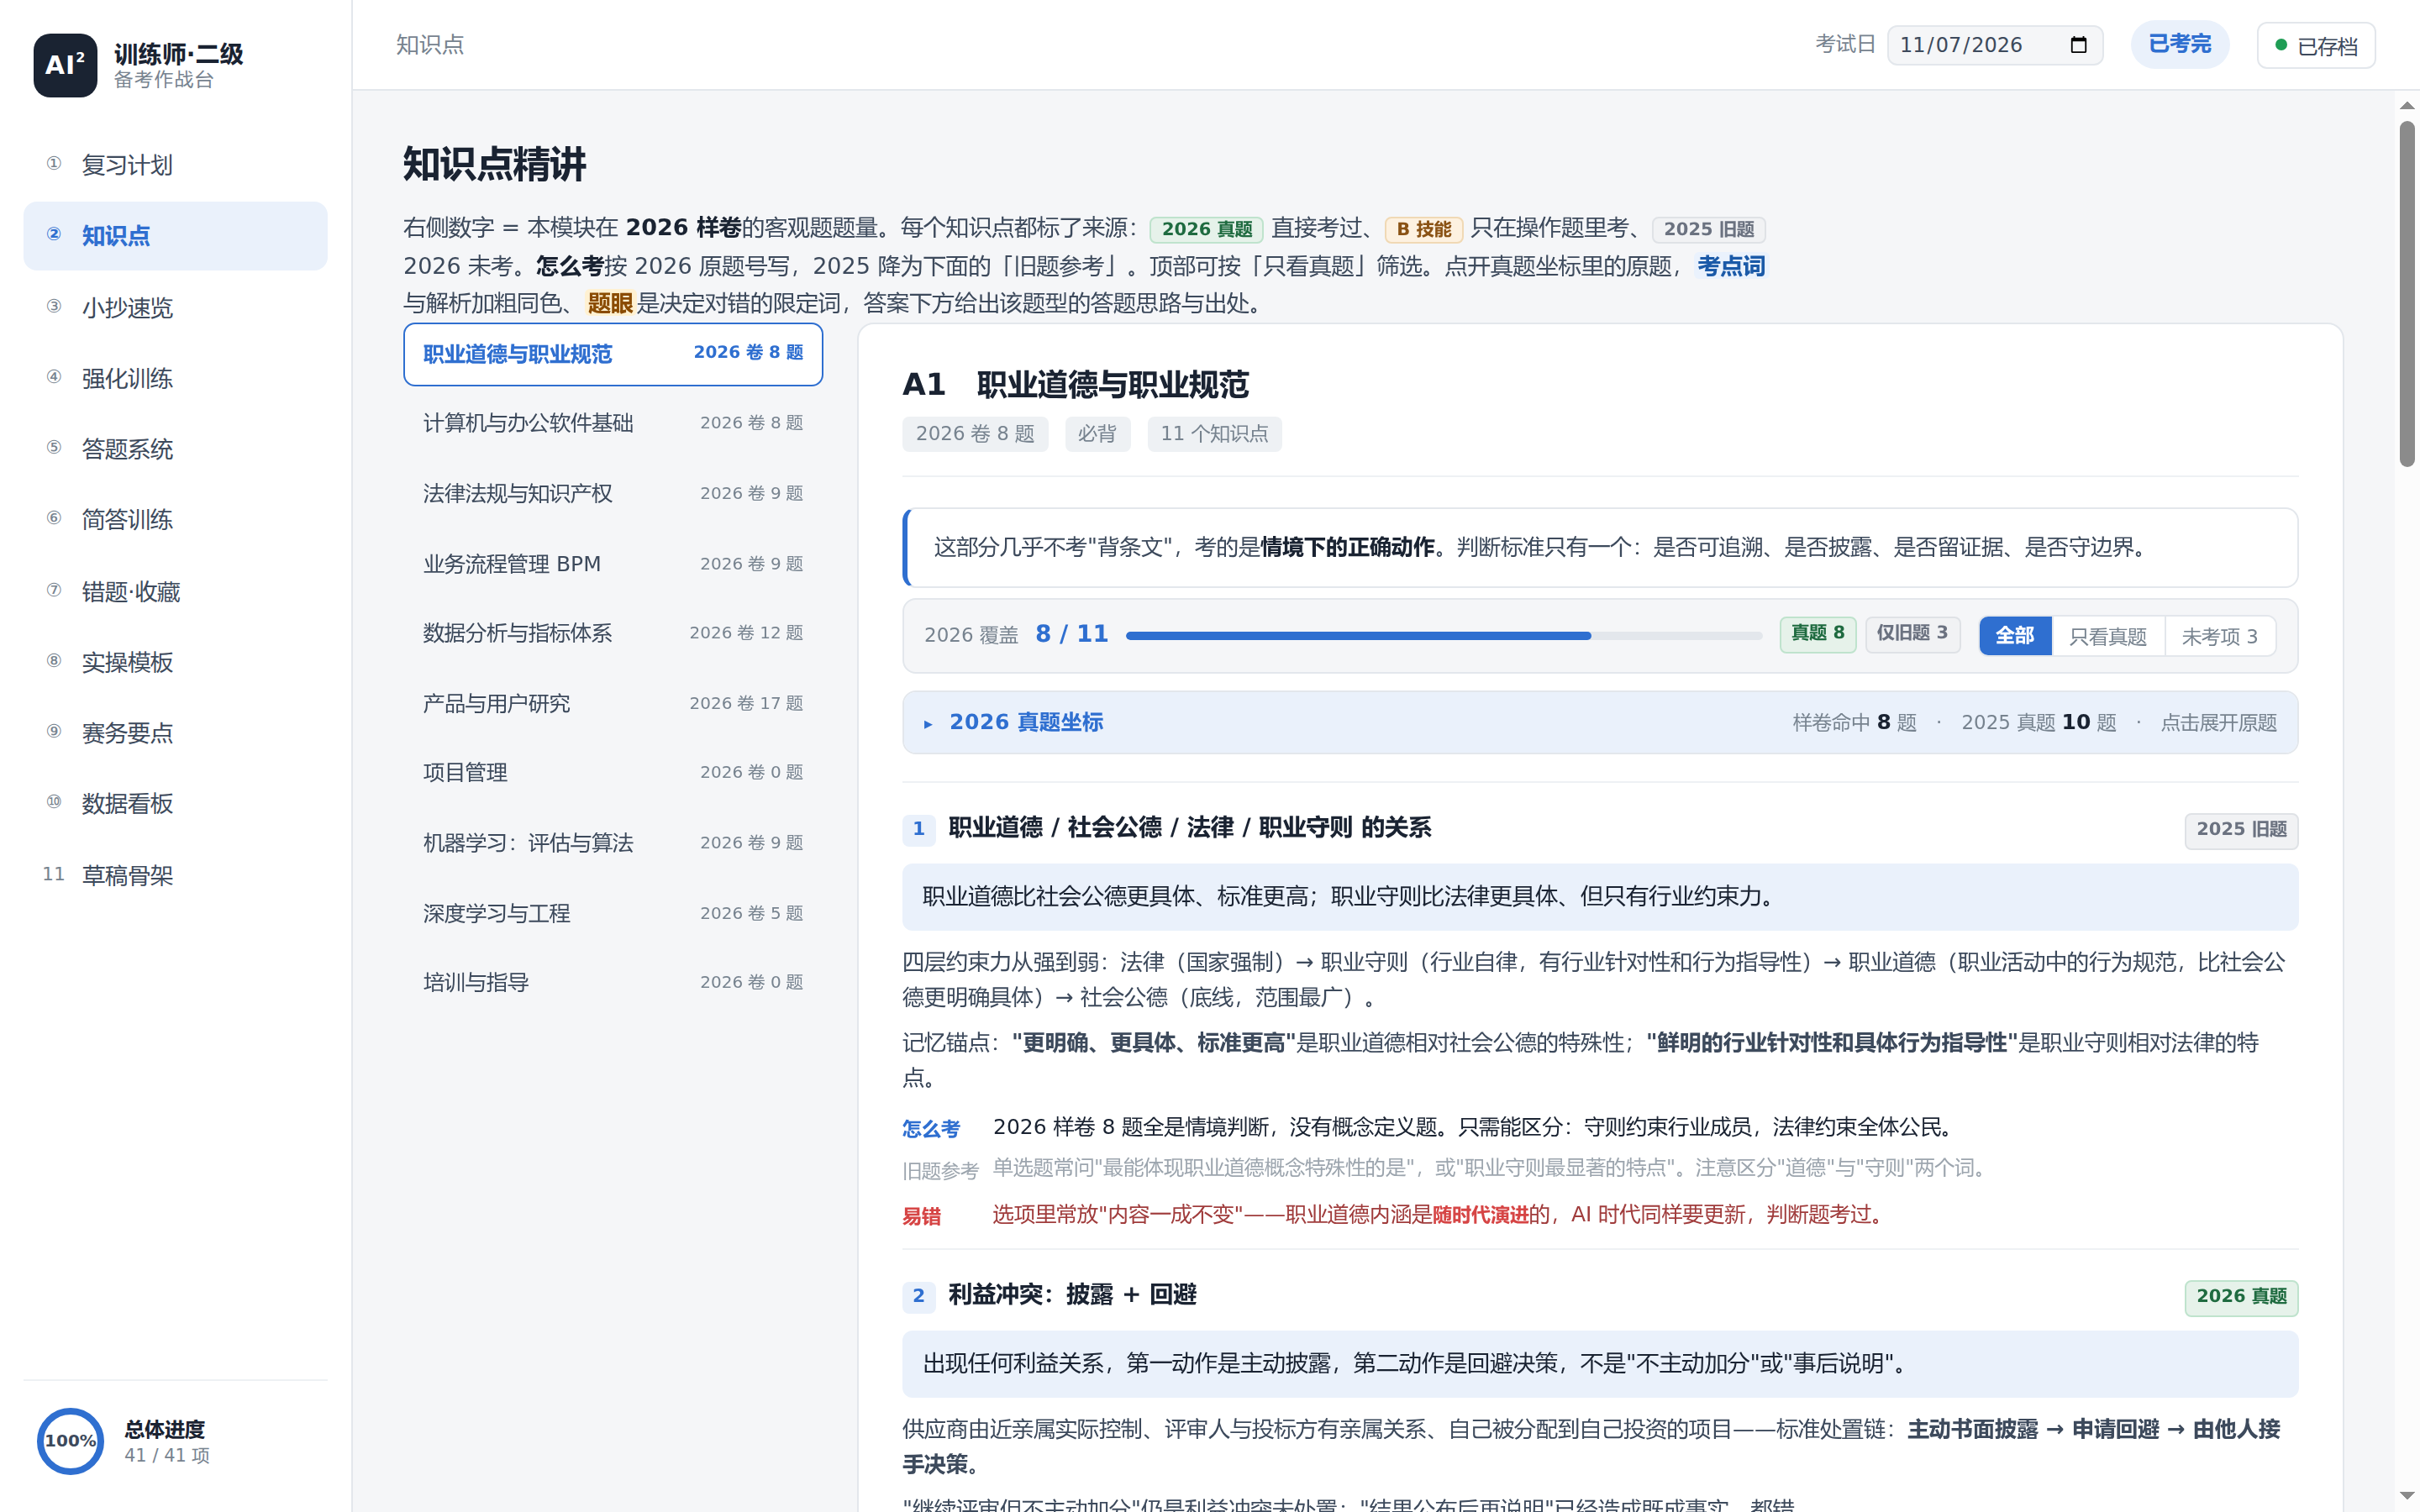
▲ 知识点页:左栏标出各模块 2026 题量,「2026 真题坐标」可展开到原题。
④ 小抄:双色语义必须两端一致
小抄是这套系统唯一的物理出口(15 页 A4,考前反复念、进场前最后翻的那份)。颜色不是装饰,是语法:深蓝定位结构、砖红加粗是必须原文照抄的判分关键词、橙色记骨架顺序、灰色考试前一天不再看。
关键设计:网页版和打印版共用同一份数据源。考前在系统里背的橙色骨架条,和纸上看到的橙色一模一样,不产生第二套记忆。
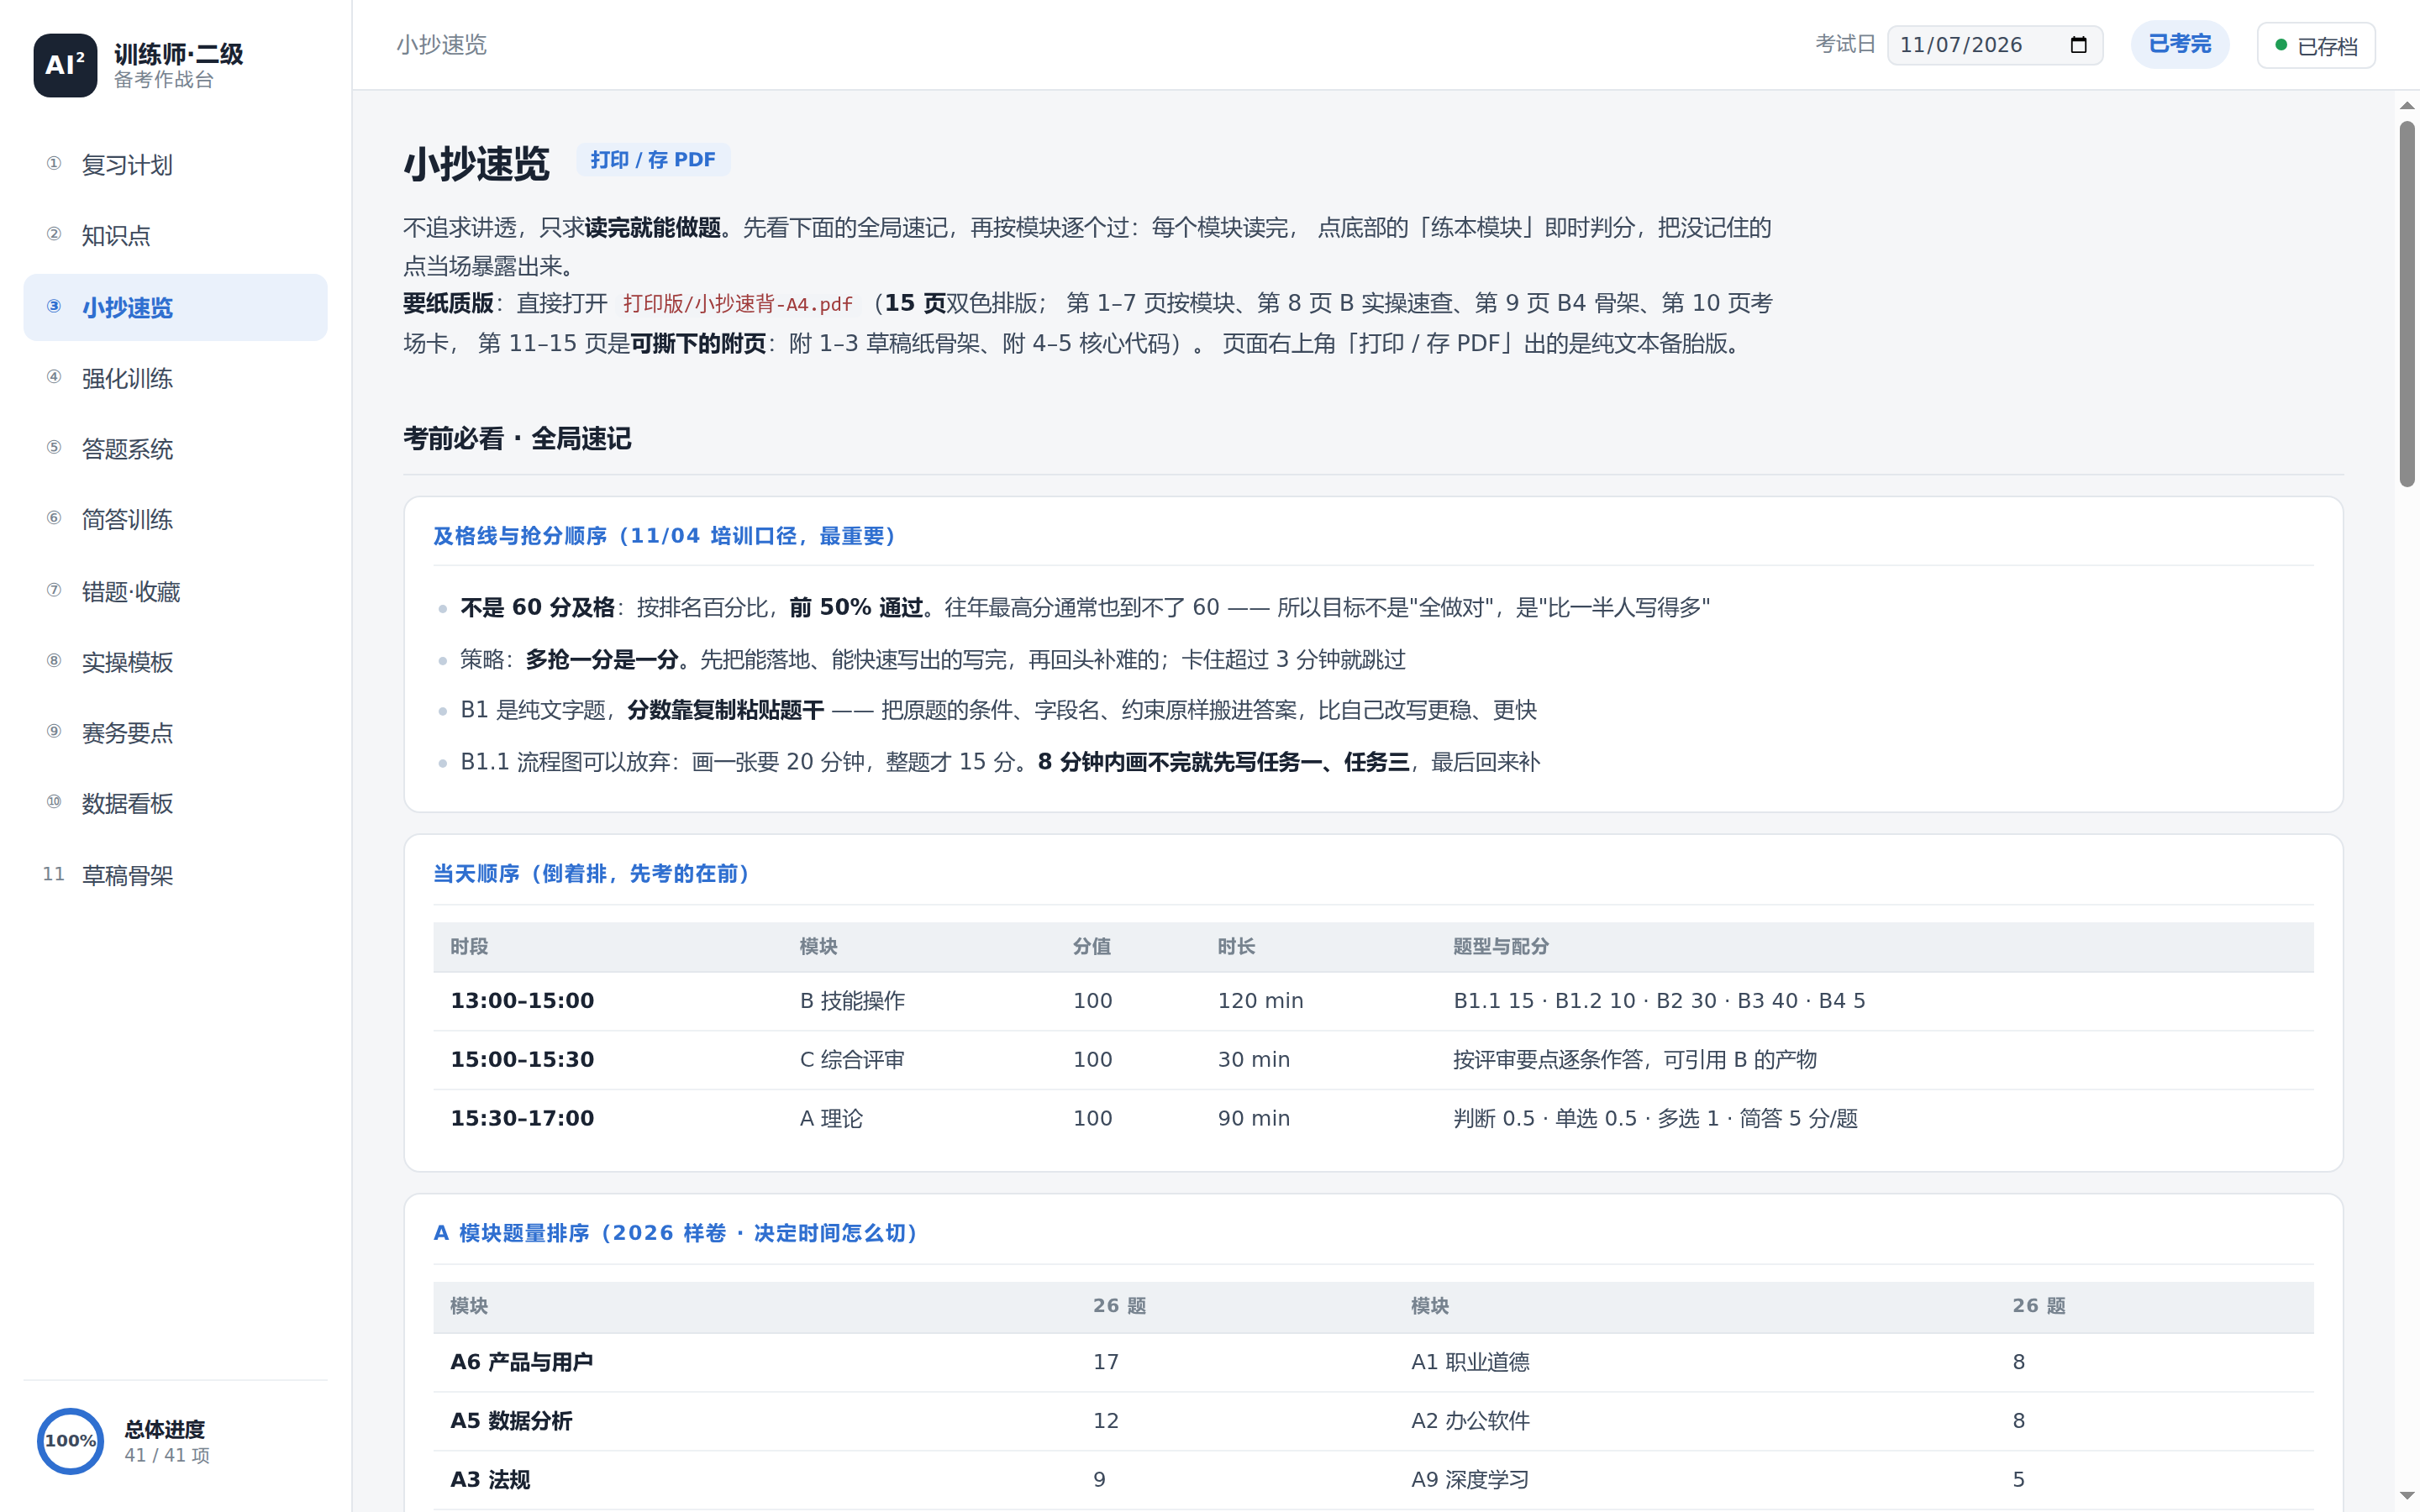
▲ 小抄速览:右上角直通 15 页 A4 打印版。
⑤ 代码填空标注:区分"题给"和"要写"
B1.2 / B2 是填空式代码题,直接贴一整段代码没用——考场上要写的只是其中 7 行和 17 行。我在数据侧给每个挖空段做标记,渲染时把「要写的行」高亮出来,顶部给统计:「共 29 行 · 填空 5 处 / 7 行」。
效果是我知道这 7 行值 7 分,其余 22 行照抄就行。考场上的时间分配从此有了依据。
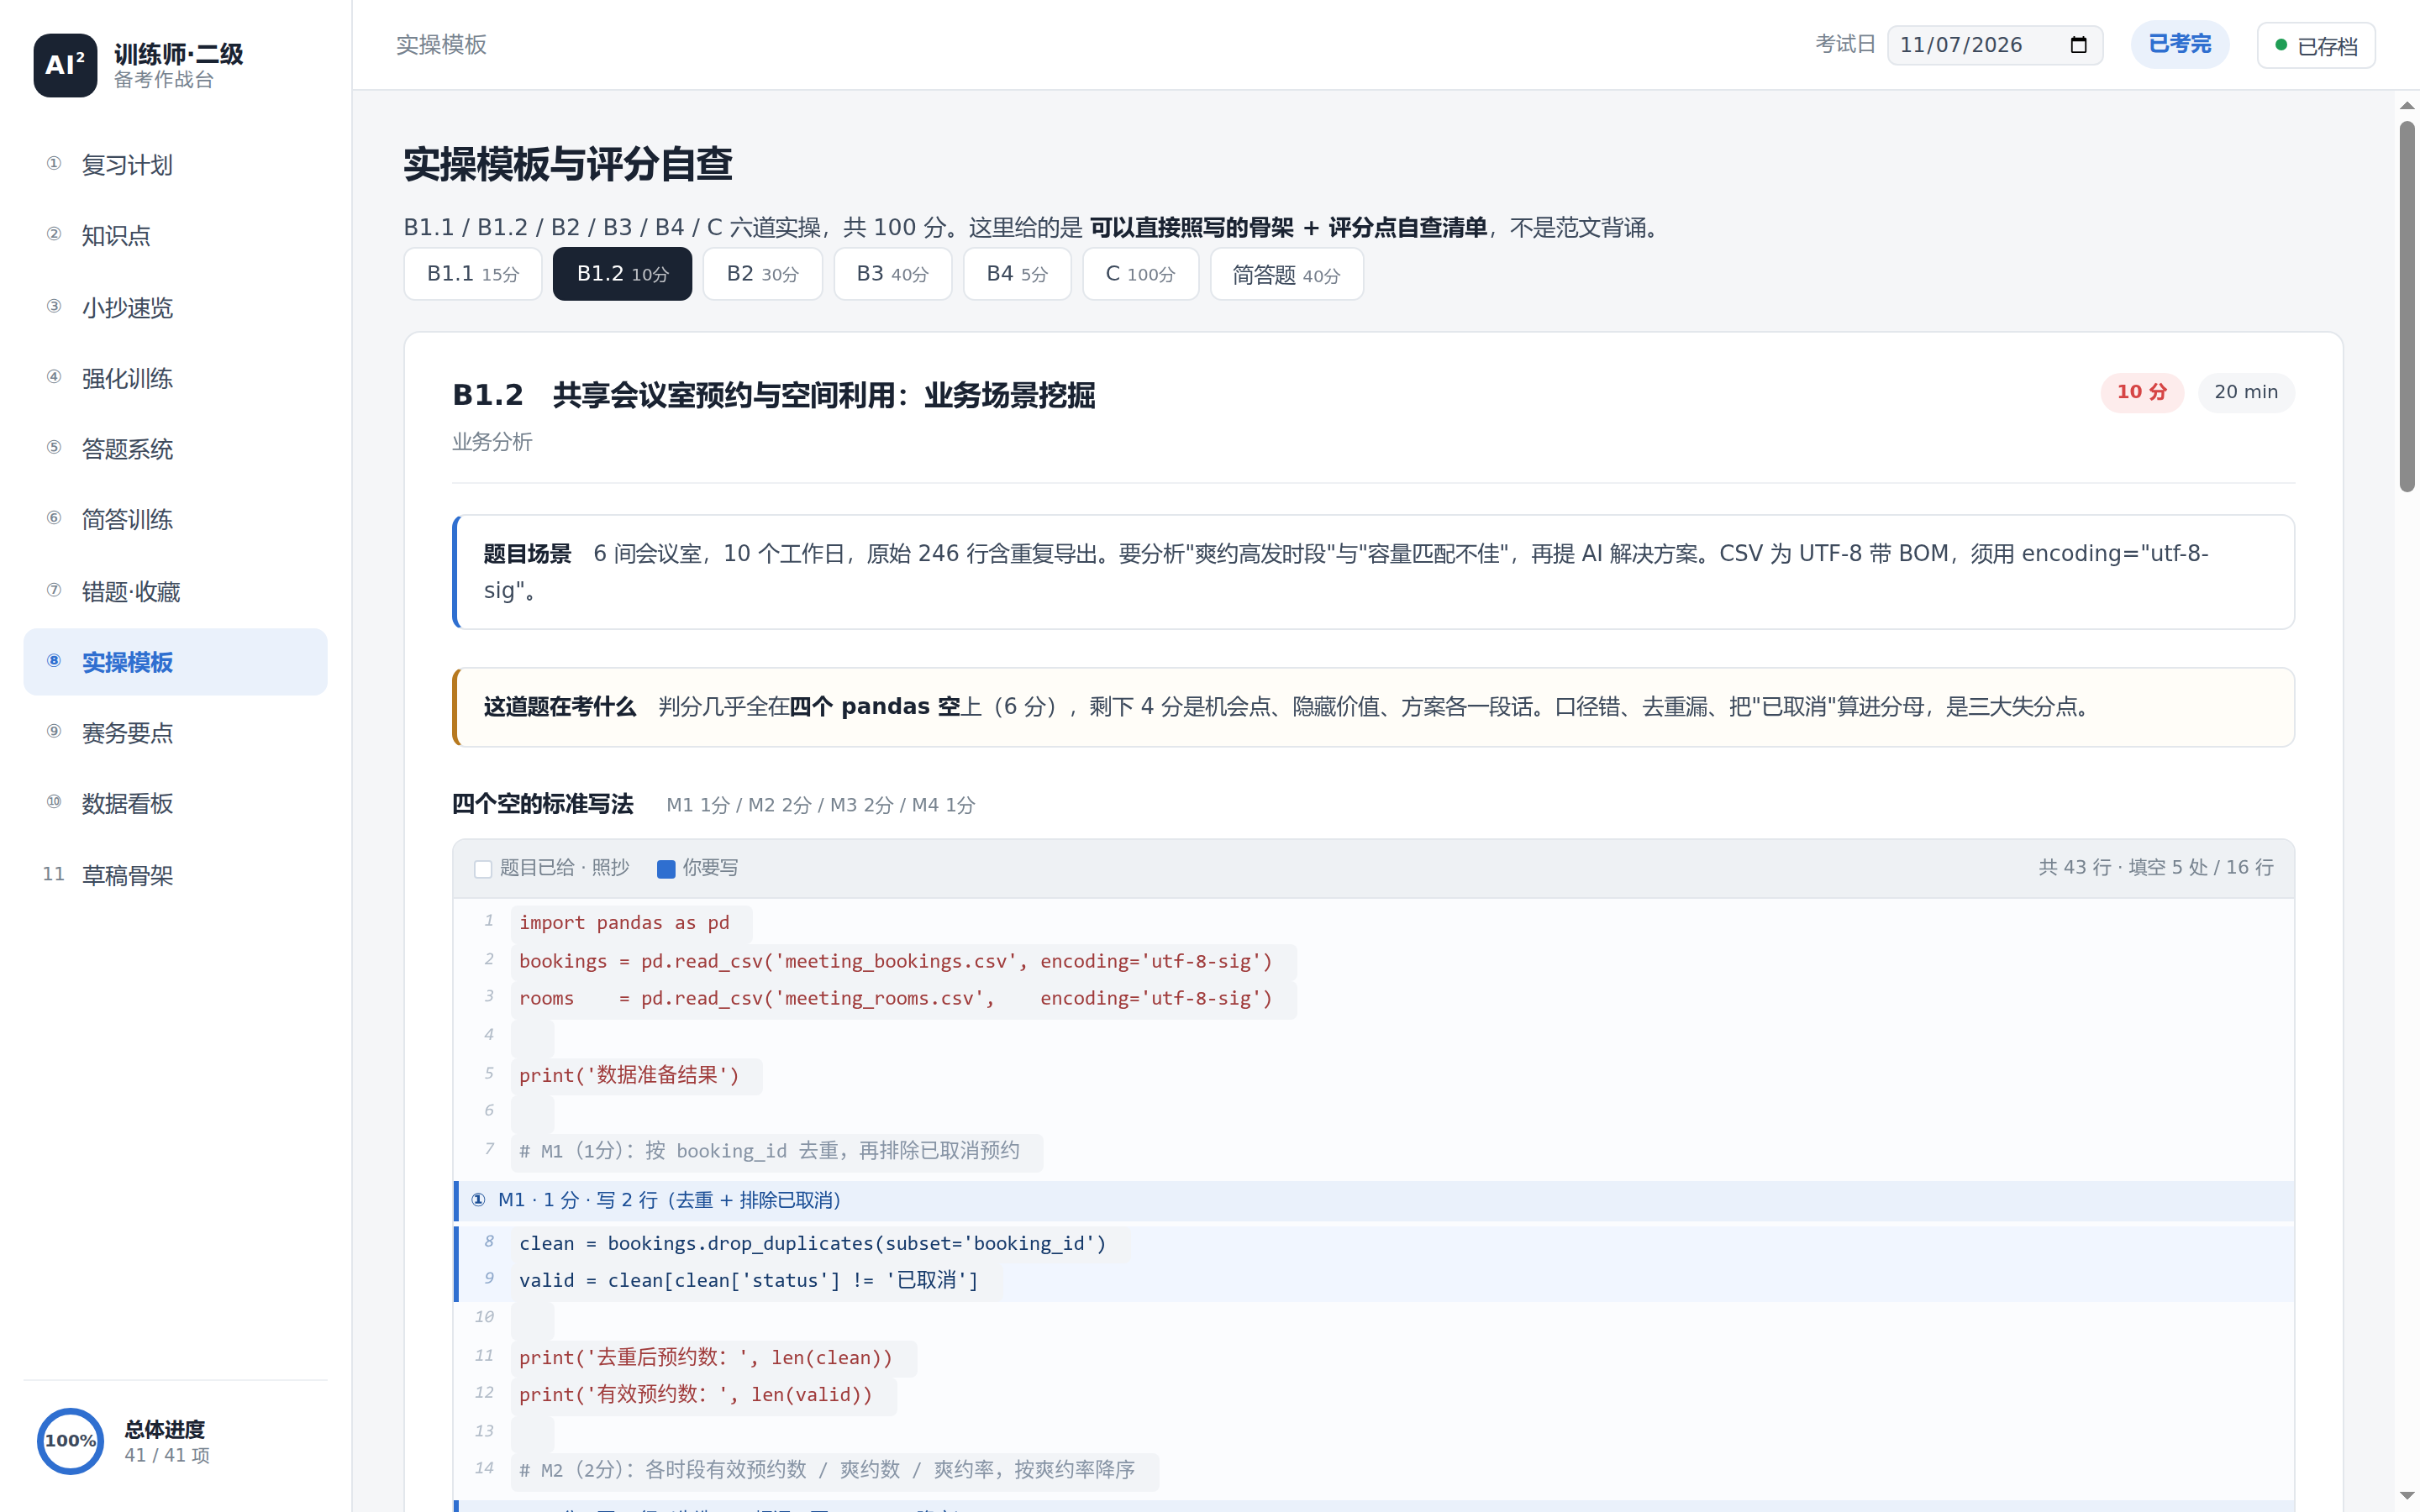
▲ 代码填空标注:灰色「题目已给·照抄」,蓝色是要写的行。
⑥ 收藏:一个设计出来却没用上的功能
收藏本的定位是"跨模块临时收纳"。实际情况:整个备考期收藏 0 条。原因不难分析:错题集已经覆盖了"需要回看"的绝大多数场景,而且自带错因标签和重做按钮;收藏只提供"存起来",没提供"之后做什么"。一个没有下一步动作的收纳功能,最终就会变成收纳本身。
这条数据我留着没删,因为它是第 7 节原则四最好的反证。
4.4 三个"看起来很小的坑",决定了能不能背下来
坑一:浏览器 origin 隔离,让所有记录凭空消失
做完 100 多道题,重新打开,记录没了。根因不是没写 localStorage,而是浏览器存储按 origin 隔离:双击 file:// 打开和用本地 http 打开是两个 origin,端口一变就是另一套空存储,各存各的,原代码还静默吞掉了写入失败。
解法是加一层磁盘存档:serve.py 固定端口,前端变成三层——localStorage → 进度存档 JSON → 每日快照(保留 40 份),并在读取任何状态前先探活两侧的时间戳,磁盘更新就回灌。
教训:只要"学习记录"是系统的核心资产,就不能把它托付给一个会随入口变化的存储层。
坑二:中文等宽对齐,决定了代码注释能不能背
代码卡的注释靠 ← 在行尾标注,第一版渲染出来箭头东倒西歪——“字符数相等"不等于"显示宽度相等”,中文占两列。写了个 12 行的宽度函数解决。
这件事的价值不在技术,而在对齐的注释才能被眼睛扫描。左歪右歪的注释会让人放弃读,读不了就背不下来。
坑三:打印排版的四个连环雷
小抄必须打印出来才叫小抄。踩到的坑:打印白页(容器位置问题)、中文表格逐字竖排(auto 布局压到最小宽度)、页底大片空白(break-inside 挂太粗)、数值列被摊成超宽(判定正则写错)。逐个修掉,最终 15 页 A4,第 11–15 页是可沿虚线撕下的附页:草稿纸骨架 + 核心代码。
5. L3 执行层:计划表是怎么变成 41 项的
5.1 计划的四次重排
| 版本 | 天数 / 项数 | 为什么改 |
|---|---|---|
| 初版 | 7 天 / 35 项 | 只有样卷,按"理论→实操"常识排序 |
| v2 | 6 天 / 29 项 | 读到赛务文件:顺序是 B→C→A,常识排序会让人在最后 90 分钟才复习理论——那时脑子已经耗尽 |
| v8 | 6 天 / 34 项 | 权重校准后,A7/A10 客观题归零,删掉对应的深挖任务,把时间挪给 A6/A5 |
| v11 | 6 天 / 41 项 | 核对计划时发现:里面全是"做题、看知识点、过错题",没有"读原题"和"背小抄" |
最后这次是我认为最值得说的一处修正。整个计划高度依赖系统,导致"用系统"和"备考"被悄悄划成等号,而原题本身和纸上骨架这两件最朴素的事没有位置。补进去的顺序明确了:先快速读原题,再小抄背诵。
5.2 最后两天的真实安排
11/06(考前 1 天):上午先裸眼扫一遍 2026 样卷 34 页,只看题面与设问,不做不查答案;然后三场模拟——B 按 120 分钟连做 5 题、C 按 30 分钟交一张功能卡、A 按 60 题限时 50 分钟;下午过错题集、背小抄附页(红字出声念 25 分钟)、背代码行,晚上确认考场路线与证件。
11/07(当天上午):翻原题 20 分钟 → 背骨架 → 背代码 → 错题只看错因 → B4 逐字稿出声念两遍 → 11:45 午餐、12:20 候考。三小时内只接触已会的内容。任何新知识都可能在考场变成焦虑。
注意「先裸眼看题」和「再背骨架」的顺序:反过来做,骨架会变成"我以为是这个意思"的滤镜。
5.3 一个反直觉的安排
「先考的先练透,最后考的靠考前 3 小时保鲜」。
B 模块 13:00 第一个考,占 120 分钟,是最大票仓,所以 11/02–11/06 的绝大部分时间给 B3(40 分)和 B2(30 分)。A 模块 15:30 最后考,此时已连考 2.5 小时,脑力最差——所以 A 不追求"深挖",只追求"考前 3 小时刚背过,短期记忆还在"。
这条安排的依据就是 L1 的第 2 条情报(顺序 B→C→A)。如果没有那一条,我会按最舒服的顺序复习,然后在考场上用完最好的两小时去做最不占分的事。
5.4 执行留痕
存档文件最后的样子(不是我回忆的,是文件里的):
| 指标 | 数值 |
|---|---|
| 有作答记录的题 | 224 / 224 |
| 错题 | 19 |
| 标记已掌握 | 19 |
| 计划任务完成 | 41 / 41 |
| 简答自评记录 | 12 / 12 |
| 每日快照 | 3 份(11-03 / 11-06 / 11-07) |
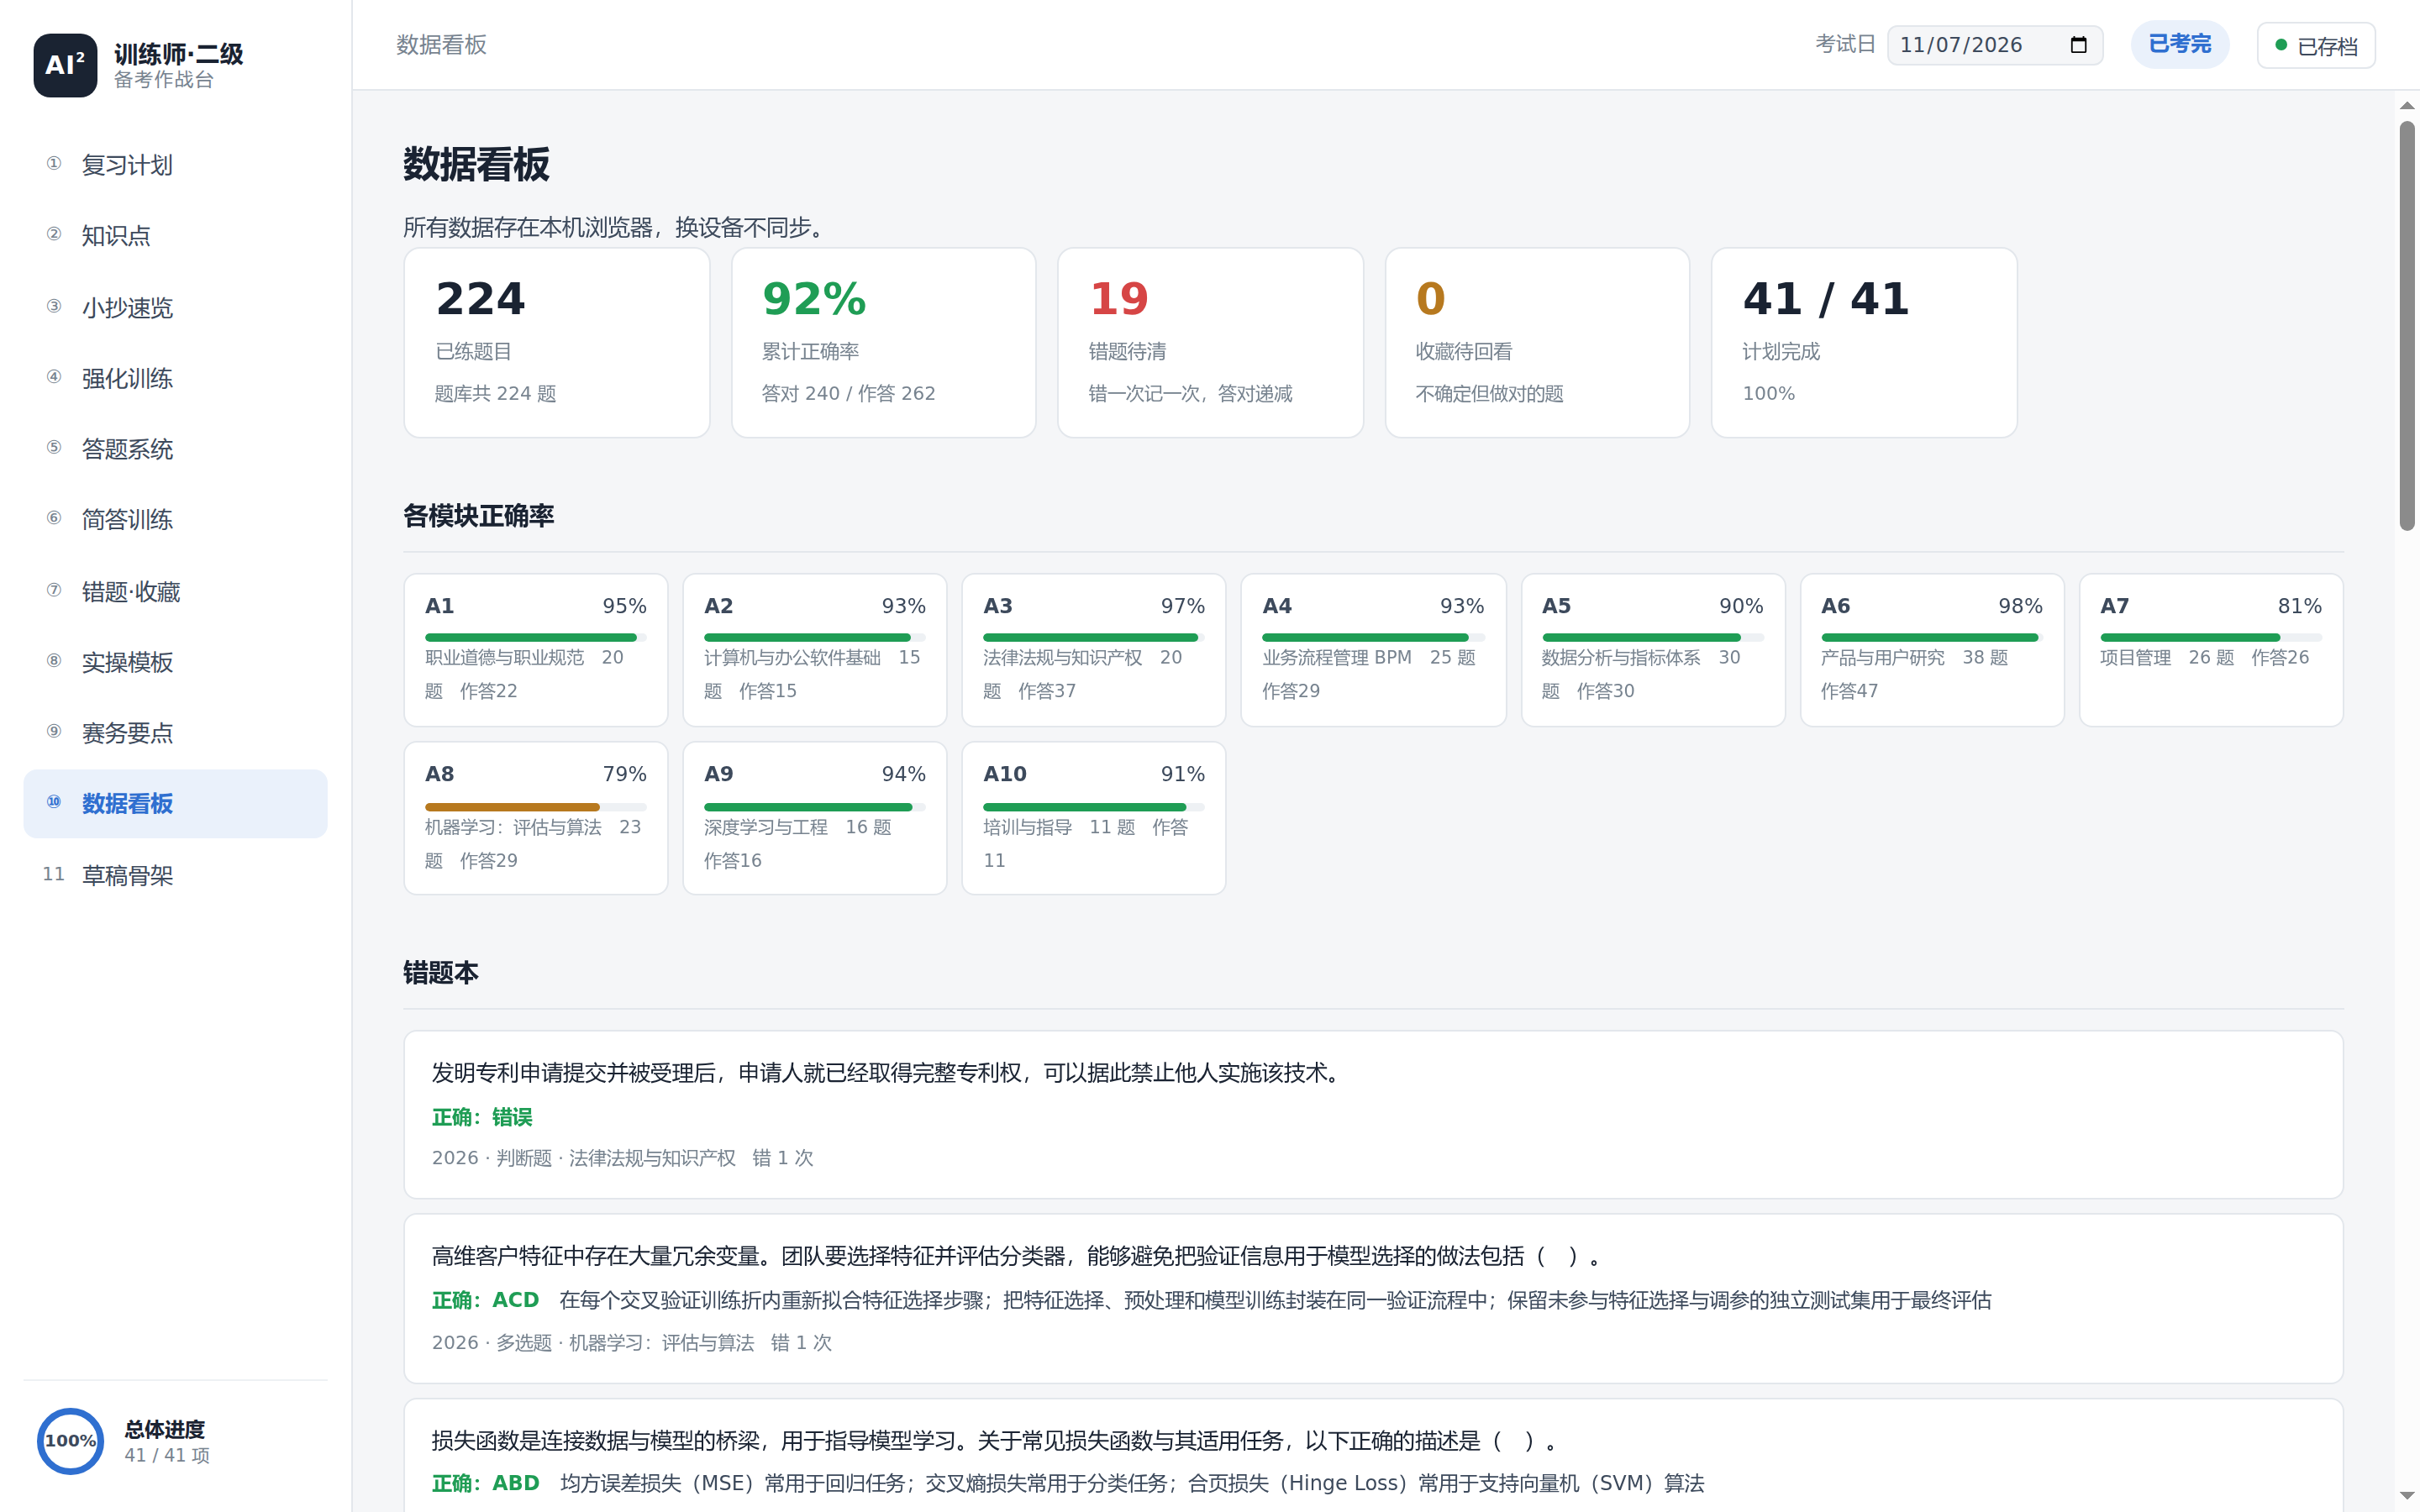
▲ 数据看板:作答留痕、正确率、错题与计划完成度一目了然。
6. L4 收口层:考前只做减法
6.1 资料语义化归档
从 20 多个散落文件,收成 7 个顶层目录:资料总览、考试规则、题面与练习册、参考答案、考试素材、课堂培训、往年真题、备考系统。删除依据全部是 MD5 实证,7 项全部进回收站而非永久删除。
6.2 考前加"锚点",不加内容
考前 2 天拿到 5 份新材料(培训纪要、练习册、参考答案、真实答卷、压缩包)。判断是:
- 理论知识点一条都不用重扫——5 份新材料全是实操材料,没有新增理论考点;
- 不加模块级试题——距开赛 2 天,大改的收益低于风险。
要补的是"锚点",也就是能让我在考场上立刻判断"我算得对不对"的数字:B1.2 去重后必须是 240 行、四个时段的爽约率基准、B2 清洗后必须是 1578 条、真实答卷的篇幅基准(1236 字 / 372 字就够)。
这几行数字是考前最值钱的东西。它把"我做得对不对"从主观判断变成对答案。
7. 复盘:AI 协作的五条原则
这几条跟具体考试无关,是我认为最可复用的部分。
原则一:先让 AI 做"可验证的事实提取",再做"创作"
情报层的每一条结论都能指回原文页码或行数(“A6 从 9 题涨到 17 题”)。而创作(写小抄、写骨架)必须建立在这些事实上。
顺序反了会得到一篇很流畅但方向错误的复习指南。
原则二:数据与视图分离,规模才能撑住迭代
11 个数据文件,每个只负责一类内容。改一个知识点不动渲染代码,改渲染不动数据。这也是为什么 4 天能迭代 11 个版本——每次改动的影响面是可控的。
原则三:同一份数据,多个出口
系统页和小抄打印版共用同一份数据源。好处有两层:改一处两边同步(不会出现"纸上写的是旧版"),以及颜色语义可以跨媒介统一。后者对记忆的影响比想象中大。
原则四:每个功能必须对应一次真实的失败
这是 4.2 那张版本表的由来。没有"打印白页"就不会有独立的打印版;没有"记录消失"就不会有 165 行的 serve.py;没有"错题看完解析还是不懂"就不会有题目精读层。
反面例子也有:v1 里做过一个我以为是刚需的功能(收藏本),整个备考期实际使用 0 次,因为错题集已经覆盖了"需要回看"的场景,而收藏只提供"存起来"、没提供"之后做什么"。没被真实问题驱动过的功能,基本是负债。
原则五:让 AI 记住决策,而不只是记住内容
每次大改都写一条结构化日志:改了什么、为什么这么改、踩了什么坑、怎么验证的。
它的价值在第三天才显现:当我问"为什么权重按题量不按分值"时,答案在文件里,不在对话历史里。跨会话协作最大的成本不是重新解释背景,而是重新讨论已经决定过的事。
8. 局限:这套方法不适合什么
诚实交代边界,比推荐更有用。
- 系统不产生知识。 7700 行代码提高的是检索效率、重复练习的留痕、以及记忆的压缩质量。它没有让我"学会"任何一条原本不懂的原理。
- 投入产出在这类考试上成立,因为题型稳定、题量有限(224 题)、有明确判分点。 换成开放式论述或需要长期积累的技能,这套形态会立刻失效。
- 有过度投入的风险。 4 天写 7700 行,本质是拿工程时间换复习时间。如果可用时间只有 1 天,正确做法是只做 L1 + 打印版,不碰系统。
- 替代不了考场判断。 系统里练的是"知道答案",考场上考的是"在 120 分钟里决定放弃哪道题"。后者只能靠模拟考练,而模拟考恰好是我花时间最少的一环。
9. 如果要复刻,按这个顺序做
不追求一次做全,按依赖顺序推进:
| 步 | 动作 | 判断标准(做不到就别往下走) |
|---|---|---|
| 1 | 清点资料,MD5 去重,建目录 | 能说清"当前有效版本是哪个文件" |
| 2 | 逐页统计真题题量与分值,算权重漂移 | 能说清"哪三个模块在涨、哪两个归零" |
| 3 | 提取赛务硬情报(顺序 / 时间 / 通过机制) | 能说清"第一科考什么,最后 90 分钟还剩多少脑力" |
| 4 | 建题库 + 答题引擎(限时、判分、解析) | 能在 50 分钟内做完一套并看到分数 |
| 5 | 加错题集(带错因标签 + 已掌握) | 错题数量能下降,而不是只增 |
| 6 | 加计划表,任务深链到视图 | 每条任务点一下就能开始,不需要想 |
| 7 | 做打印版小抄(双色语义与网页一致) | 能通过"合上电脑只念纸"复述骨架 |
| 8 | 考前 12 小时:只翻原题 + 背骨架,不学新东西 | —— |
第 4 步之前不要做第 7 步。没有练过的内容,抄成小抄也只是抄。
10. 结语
这次最有用的一步,不是写了多少代码,而是第 3.2 节那张权重漂移表——它让 4 天的时间没有花在会消失的考点上。
剩下的一切(题库、错题、计划、小抄、存档)都是为了让那张表能被持续执行:能练、能错、能记住、能带走。
AI 在其中做的事情很朴素——把"愿意读完 300 页材料并数清题量"这件事变得便宜,把"改第四版时还记得第一版为什么这么定"变得可能。它不是更聪明的老师,是一个不会烦的工程搭档。
配套材料:备考系统源码 7,726 行(07-备考系统/)、小抄 15 页 A4(07-备考系统/打印版/小抄速背-A4.pdf)、资料归档说明(00-资料总览/README-资料总览.md)。