《Attention Is All You Need》论文解读
核心信息
- 标题: Attention Is All You Need
- 标题翻译: 注意力就是你所需的全部
- 作者: Ashish Vaswani、Noam Shazeer、Niki Parmar、Jakob Uszkoreit、Llion Jones、Aidan N. Gomez、Łukasz Kaiser、Illia Polosukhin
- 机构:
Google Brain、Google Research、University of Toronto - 发表时间: 2017
- 发表渠道:
NIPS 2017(第 31 届神经信息处理系统大会) - arXiv: 1706.03762
- 论文链接: arXiv 原文
- 代码 / 项目: tensorflow/tensor2tensor
- 数据 / 资源:
WMT 2014英德与英法翻译数据、Penn Treebank(WSJ)句法分析语料 - 论文类型: AI 方法类(序列转导网络架构)
原文摘要翻译
占主导地位的序列转导模型基于复杂的循环或卷积神经网络,包含一个编码器和一个解码器。
表现最好的模型还会通过注意力机制把编码器和解码器连接起来。
我们提出一种全新的简洁网络架构 Transformer,它完全基于注意力机制,彻底摒弃了循环和卷积。
在两个机器翻译任务上的实验表明,这类模型在质量上更优,同时具有更强的可并行性,所需训练时间也显著更短。
我们的模型在 WMT 2014 英德翻译任务上取得 BLEU 28.4,比包括集成模型在内的既有最好结果高出 2 个 BLEU 以上。
在 WMT 2014 英法翻译任务上,我们的模型在八块 GPU 上训练 3.5 天后,取得 41.8 的单模型最好 BLEU 分数,训练成本仅为文献中最好模型的很小一部分。
我们通过把 Transformer 成功应用于英文成分句法分析(分别在训练数据充足和受限两种条件下),证明它能很好地泛化到其他任务。
创新点
- 完全去循环、去卷积的纯注意力架构:这是第一个完全依靠自注意力计算输入输出表示的序列转导模型,打破了「注意力只是循环网络的附件」这一惯例,让序列内依赖不再受制于时间步展开。
- 缩放点积注意力:在点积注意力中引入 $1/\sqrt{d_k}$ 缩放因子,用方差论证解释了为什么大维度点积会把
softmax推向梯度饱和区,是一个几乎零成本但决定训练稳定性的关键细节。 - 多头注意力:把查询、键、值线性投影 $h$ 次后并行做注意力再拼接,让模型在不同表示子空间里同时关注不同位置,直接缓解加权平均造成的有效分辨率损失。
- 正弦/余弦位置编码:用固定频率的周期函数注入位置信息,利用「任意固定偏移都是位置编码的线性函数」这一性质方便模型学相对位置,且理论上可外推到更长序列。
- 统一维度的深层堆叠设计:所有子层与嵌入层输出统一为 $d_{model}=512$,配合残差连接与层归一化,使 $N=6$ 层的编码器与解码器可以稳定堆叠训练。
- 把训练成本纳入结果主张:论文不仅报告
BLEU,还给出训练FLOPs的估算口径与对比,证明高质量与低成本可以同时达成,这一论证方式后来成为架构论文的标准配置。
一句话总结
Transformer 用纯多头自注意力取代循环与卷积,以常数级的最长依赖路径和高度可并行的计算方式,在 WMT 2014 翻译上用低一个量级的训练成本刷新最好成绩,并把优势泛化到英文句法分析。
研究问题
论文要解决的是序列转导(输入一个序列、输出一个序列)建模中的一个根本性结构问题:如何在不引入顺序计算的前提下直接建模任意两个位置之间的依赖。
循环神经网络(含长短期记忆与门控循环单元)沿符号位置逐步展开计算,第 $t$ 步的隐状态 $h_t$ 依赖 $h_{t-1}$,这使样本内计算本质上是串行的。 当序列变长时,显存限制又迫使跨样本的批大小收缩,并行度进一步恶化;因子化技巧与条件计算缓解了效率问题,但顺序计算的根本约束没有被消除。
卷积路线(ConvS2S、ByteNet、Extended Neural GPU)把所有位置的表示并行计算。
但两个任意位置之间建立关联所需的操作数随距离增长:ConvS2S 线性、ByteNet 对数级。
层数不够深时,远距离位置之间根本不在彼此的感受野里,长程依赖因此很难学。
注意力机制本身早已能不受距离约束地建模依赖,但在绝大多数工作中仍与循环网络捆绑使用。 于是论文的核心研究问题可以拆成三点:
- 能否用纯注意力机制构建完整可用的编码器-解码器转导模型,彻底去掉循环与卷积?
- 这样的结构能否在保持(甚至提升)翻译质量的同时,显著提高训练并行度、降低训练成本?
- 它学到的能力是否只对翻译有效,还是可以迁移到结构约束更强的其他序列任务?
数据与任务定义
数据来源
WMT 2014英德翻译:约 450 万句对,用字节对编码(BPE)构建约 37000 词元的源-目标共享词表。WMT 2014英法翻译:规模大得多,3600 万句,用约 32000 词元的词级切分词表。- 英文成分句法分析:
Penn Treebank的WSJ部分,仅约 4 万句训练数据;半监督设置额外引入高置信度语料与BerkleyParser语料,合计约 1700 万句。
任务定义
翻译任务是标准的自回归序列转导:输入源语言词元序列,逐位置生成目标语言词元,评测指标是 newstest2014 上的 BLEU。
句法分析任务的输出是线性化的成分句法树,特点是输出受强结构约束且显著长于输入,评测指标是 WSJ 第 23 节上的 F1。
训练批处理按近似序列长度组批,每批约含 25000 个源词元与 25000 个目标词元。
句法分析实验只用 16K(WSJ 单独设置)或 32K(半监督设置)词表,除学习率、dropout 与束搜索宽度外,其余参数沿用英德翻译的基准配置。
方法主线
机制流程
- 输入构造:输入是源序列的词元序列,操作是查嵌入矩阵并乘以 $\sqrt{d_{model}}$,再与同维度的正弦位置编码逐元素相加;输出送入编码器栈底部(解码器侧同样构造目标序列嵌入)。
- 编码器堆叠:输入是上一层输出,操作是「多头自注意力 → 残差 + 层归一化 → 逐位置前馈网络 → 残差 + 层归一化」重复 $N=6$ 层,每个子层都按「残差 + 归一化」组合,可简写为 $y=LN(x+f(x))$;输出去向是编码器记忆表示,交给解码器。
- 解码器堆叠:输入是右移一位的目标嵌入与编码器记忆表示,操作是三个子层循环 $N=6$ 层——带掩码的多头自注意力(把非法未来位置的
softmax输入置为负无穷)、以解码器为查询、以编码器记忆为键和值的编码器-解码器注意力、逐位置前馈网络,每层同样配残差与归一化;输出去向是每个位置的隐表示。 - 输出投影与自回归生成:输入是解码器顶层输出,操作是共享权重的线性变换加
softmax得到下一词元概率分布;输出去向是按自回归方式拼回输入端生成下一个词元,直到终止条件满足。
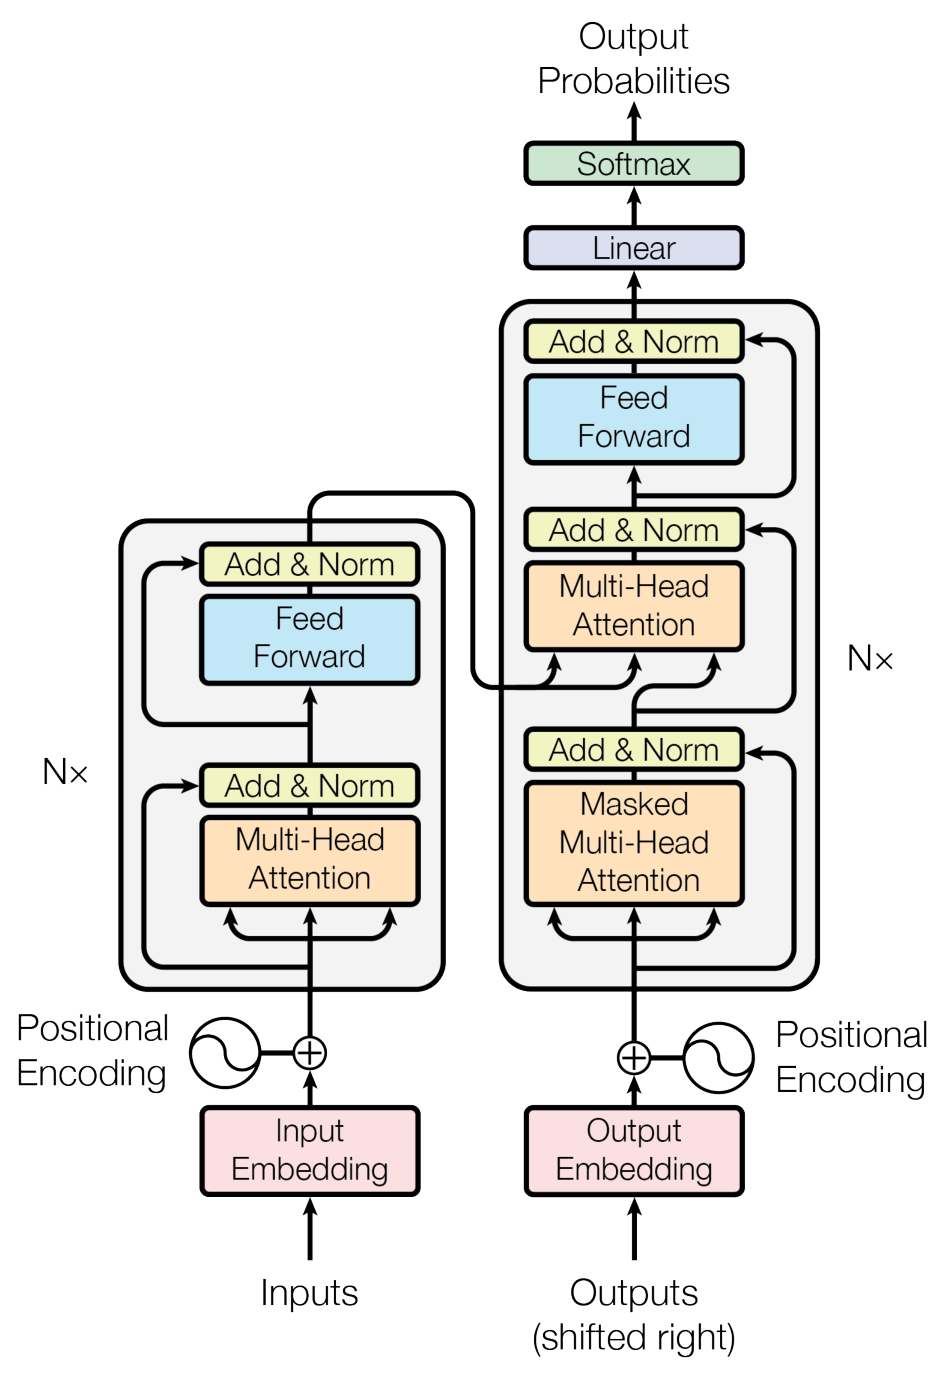 论文原图编号:Fig. 1。左右对称的编码器-解码器总览图,把上面机制流程的四步链路一次画清。
模型结构
注意力函数把一个查询与一组键值对映射为输出:输出是值的加权求和,权重由查询与各键的兼容性函数给出。 论文的核心注意力是缩放点积注意力,批量形式为:
$$ \mathrm{Attention}(Q,K,V)=\mathrm{softmax}!\left(\frac{QK^{\top}}{\sqrt{d_k}}\right)V $$
缩放因子 $1/\sqrt{d_k}$ 的动机是方差控制:若查询与键的分量独立、零均值、单位方差,其点积的方差是 $d_k$,维度一大点积幅值就大,softmax 会进入梯度极小的区域。
与加性注意力相比,点积注意力在实现上可以直接调用高度优化的矩阵乘法内核,速度和空间效率都更好。
多头注意力把查询、键、值分别用 $h$ 组不同的线性投影降到 $d_k$、$d_k$、$d_v$ 维,并行做注意力后拼接再投影回 $d_{model}$ 维。 论文取 $h=8$、$d_k=d_v=d_{model}/h=64$,由于每头维度降低,总计算量与单头全维度注意力相当。 多头的价值在于不同头可以落在不同表示子空间里关注不同位置;单头的加权平均会把这种多样性抹掉。
三种注意力用法分工明确:解码器的编码器-解码器注意力用解码器查询去检索编码器全部位置;编码器自注意力让每个位置聚合全句信息;解码器自注意力靠掩码保证自回归性,预测第 $i$ 位只依赖小于 $i$ 的已知输出。
逐位置前馈网络对每个位置施加同一组带 ReLU 的两层线性变换,等价于核宽为 1 的两次卷积:
$$ \mathrm{FFN}(x)=\max(0,,xW_1+b_1)W_2+b_2 $$
输入输出维度是 $d_{model}=512$,内层维度是 $d_{ff}=2048$。
训练目标
论文沿用自回归序列转导的标准目标,即已知前缀下逐词元的对数似然,并用值为 $\epsilon_{ls}=0.1$ 的标签平滑修正。
标签平滑会让困惑度变差(模型变得更不确定),但能提升准确率与 BLEU。
正则化除标签平滑外还有残差 dropout(子层输出加残差前、以及嵌入与位置编码之和处,基准模型丢弃率 0.1)。
推理与采样链路
解码用束搜索,束宽 4、长度惩罚 $\alpha=0.6$,最大输出长度设为输入长度加 50,能提前终止就提前终止。 基准模型的最终结果取最后 5 个检查点(每 10 分钟写一个)的平均,大模型取最后 20 个检查点的平均。 超参数是在开发集上实验选定的——复现时这条不能省略。
关键实现细节
学习率不走常数或纯衰减,而用「先线性升温、后按步数逆平方根衰减」的调度:
$$ lrate = d_{model}^{-0.5}\cdot\min\bigl(step_num^{-0.5},;step_num\cdot warmup_steps^{-1.5}\bigr) $$
其中 $warmup_steps=4000$。
优化器是 Adam($\beta_1=0.9$、$\beta_2=0.98$、$\epsilon=10^{-9}$)。
硬件是单机八块 P100:基准模型 0.4 秒一步、共 10 万步(12 小时),大模型 1.0 秒一步、共 30 万步(3.5 天)。
嵌入层与预 softmax 线性变换共享同一权重矩阵,嵌入权重乘以 $\sqrt{d_{model}}$。
关键结果
主结果与强基线
newstest2014 上的主结果与训练成本对比如下(BLEU 与 FLOPs 均按英德 / 英法两列,「—」表示原表未列):
| 模型 | 英德 BLEU | 英法 BLEU | 训练成本(英德 / 英法,FLOPs) |
|---|---|---|---|
ByteNet | 23.75 | — | — |
Deep-Att + PosUnk | — | 39.2 | — / 1.0×10^20 |
GNMT + RL | 24.6 | 39.92 | 2.3×10^19 / 1.4×10^20 |
ConvS2S | 25.16 | 40.46 | 9.6×10^18 / 1.5×10^20 |
MoE | 26.03 | 40.56 | 2.0×10^19 / 1.2×10^20 |
Deep-Att + PosUnk(集成) | — | 40.4 | — / 8.0×10^20 |
GNMT + RL(集成) | 26.30 | 41.16 | 1.8×10^20 / 1.1×10^21 |
ConvS2S(集成) | 26.36 | 41.29 | 7.7×10^19 / 1.2×10^21 |
Transformer(base) | 27.3 | 38.1 | 3.3×10^18 |
Transformer(big) | 28.4 | 41.8 | 2.3×10^19 |
Table 2:Transformer 在英德与英法翻译上同时取得更高 BLEU 与更低训练成本。原表中 Transformer 两行的训练成本只给出一个数值。
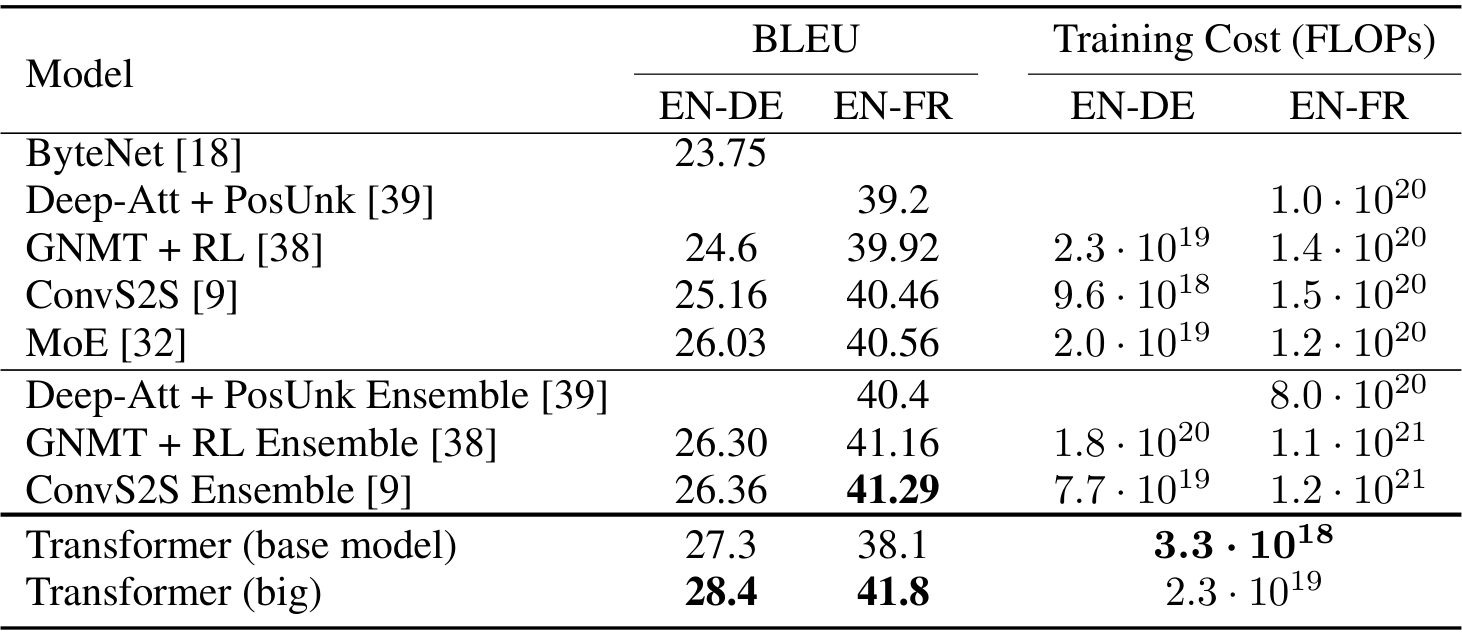 论文原图编号:Table 2。原表截图,内容与上方重建表格一致,保留原版式便于核对。
三个层次的结论值得分开看:
- 英德:大模型 28.4 比此前所有结果(含集成)高 2.0
BLEU以上;更激进的是基准模型 27.3 也已经超过全部已发表单模型和集成,而它的训练成本(3.3×10^18)比最便宜的基线ConvS2S(9.6×10^18)还低。 - 英法:大模型 41.8 刷新单模型最好成绩,训练成本不到此前最好模型(
Deep-Att + PosUnk,1.0×10^20)的四分之一。 - 数字口径提醒:摘要与
Table 2都写 41.8,但正文 6.1 的文字写的是 41.0,属于论文自身的文本不一致,引用时应以表格的 41.8 为准并知晓差异存在。
消融到底说明了什么
消融全部在英德开发集(newstest2013)上做、且不做检查点平均,PPL 为按词级切分的逐词元困惑度:
| 变化项 | 具体设置 | PPL(dev) | BLEU(dev) | 参数量(百万) |
|---|---|---|---|---|
| 基准 | $h{=}8$,$d_k{=}d_v{=}64$ | 4.92 | 25.8 | 65 |
| 头数(A) | $h{=}1$,$d_k{=}d_v{=}512$ | 5.29 | 24.9 | 65 |
| 头数(A) | $h{=}4$,$d_k{=}d_v{=}128$ | 5.00 | 25.5 | 65 |
| 头数(A) | $h{=}16$,$d_k{=}d_v{=}32$ | 4.91 | 25.8 | 65 |
| 头数(A) | $h{=}32$,$d_k{=}d_v{=}16$ | 5.01 | 25.4 | 65 |
| 键维度(B) | $d_k{=}16$ | 5.16 | 25.1 | 58 |
| 键维度(B) | $d_k{=}32$ | 5.01 | 25.4 | 60 |
| 深度(C) | $N{=}2$ | 6.11 | 23.7 | 36 |
| 深度(C) | $N{=}4$ | 5.19 | 25.3 | 50 |
| 深度(C) | $N{=}8$ | 4.88 | 25.5 | 80 |
| 宽度(C) | $d_{model}{=}256$,$d_{ff}$ 相应减半 | 5.75 | 24.5 | 28 |
| 宽度(C) | $d_{model}{=}1024$,$d_{ff}$ 相应加倍 | 4.66 | 26.0 | 168 |
| 前馈内层(C) | $d_{ff}{=}1024$ | 5.12 | 25.4 | 53 |
| 前馈内层(C) | $d_{ff}{=}4096$ | 4.75 | 26.2 | 90 |
| 丢弃率(D) | $P_{drop}{=}0$ | 5.77 | 24.6 | 65 |
| 丢弃率(D) | $P_{drop}{=}0.2$ | 4.95 | 25.5 | 65 |
| 标签平滑(D) | $\epsilon_{ls}{=}0$ | 4.67 | 25.3 | 65 |
| 标签平滑(D) | $\epsilon_{ls}{=}0.2$ | 5.47 | 25.7 | 65 |
| 位置编码(E) | 学习式位置嵌入替代正弦 | 4.92 | 25.7 | 65 |
| 大模型 | $N{=}6$,$d_{model}{=}1024$,$d_{ff}{=}4096$,$h{=}16$,$P_{drop}{=}0.3$,30 万步 | 4.33 | 26.4 | 213 |
Table 3:架构变体消融。原表未列出的值与基准一致;宽度(C)两行的 $d_k=d_v=d_{model}/h$ 随宽度缩放。
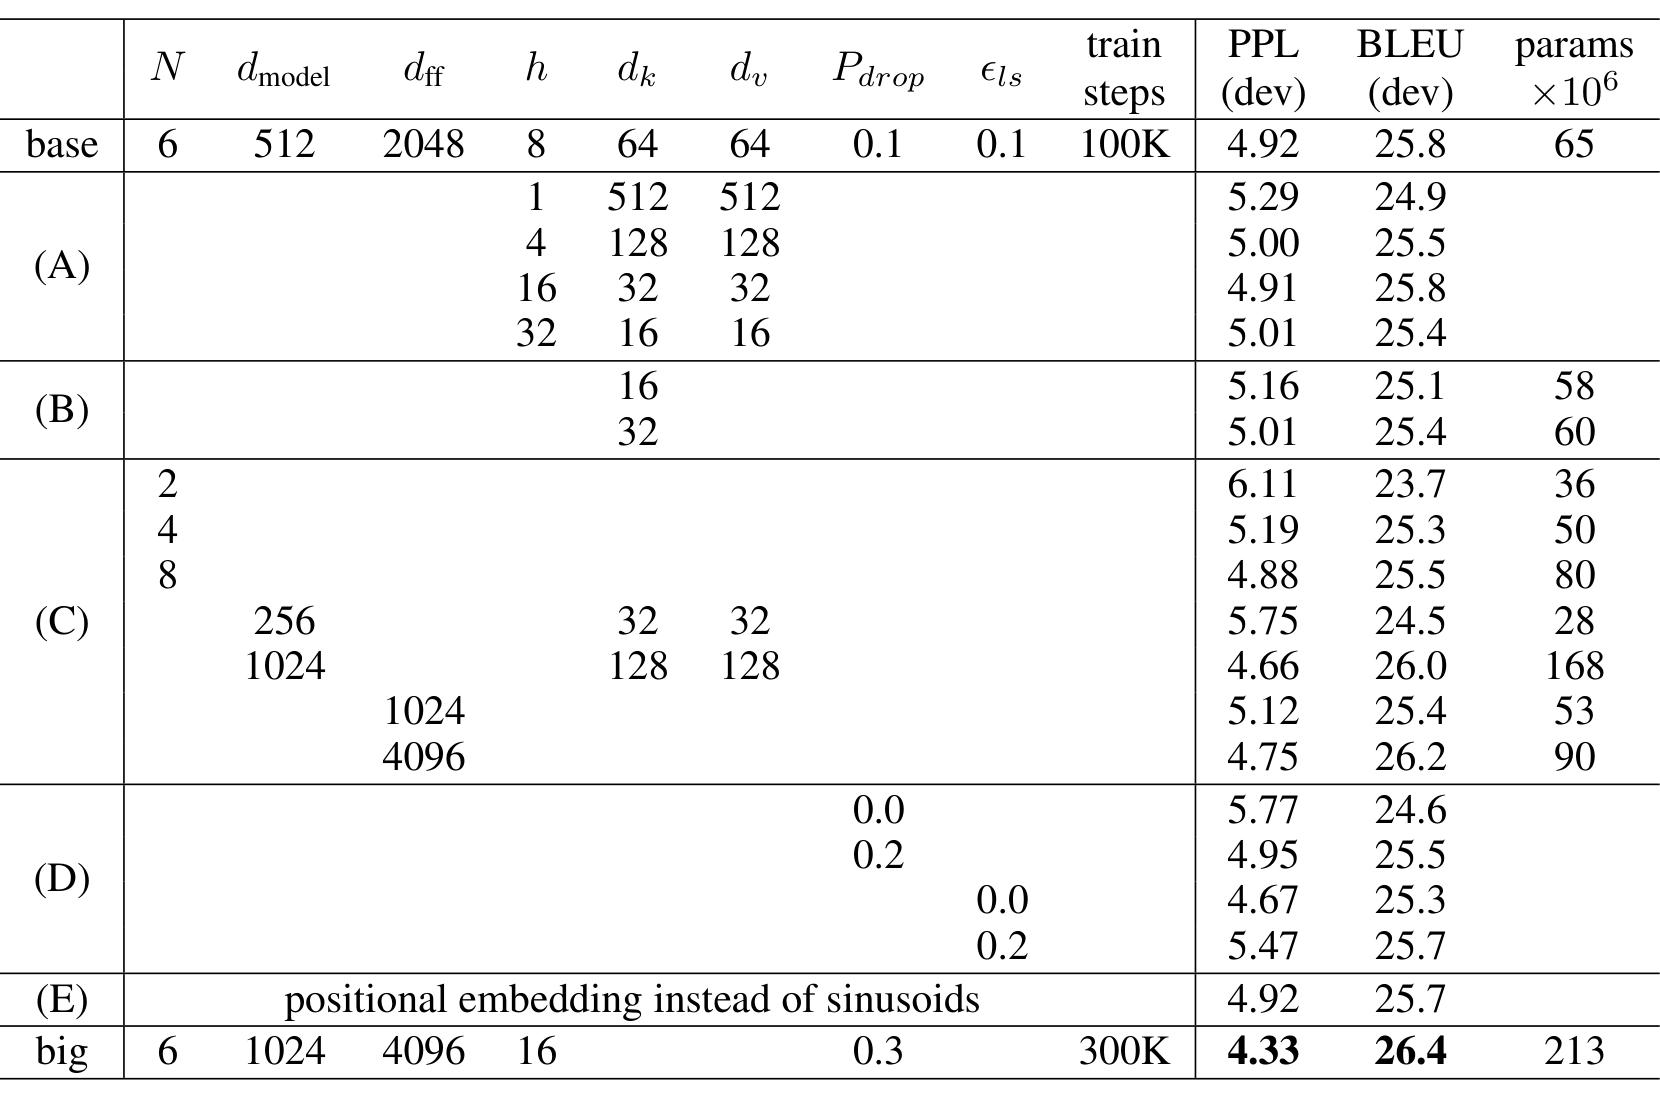 论文原图编号:Table 3。原表截图,参数量列为原始数值,便于核对消融设置。
每组消融真正说明的问题:
- 头数(A):计算量保持恒定时,单头比最好设置低 0.9
BLEU,但头数过多(32 头、每头 16 维)同样掉点。多头的价值不是「越多越好」,而是保持每头足够维度的前提下换取子空间多样性。 - 键维度(B):单独把 $d_k$ 从 64 减到 16/32 就伤到 0.7
BLEU,连参数量变少都救不回来。作者由此推断兼容性判定并不容易,点积之外可能有更优的兼容性函数——注意这是推断,不是被验证的结论。 - 规模(C):深度、宽度、前馈内层三个方向单调地「越大越好」,但消融没有隔离参数量与结构比例的贡献,不能证明收益来自深度而非参数。
- 正则化(D):去掉
dropout是全场最大退化(BLEU掉 1.2、困惑度恶化到 5.77),过拟合是这个架构在中等规模数据上的主要敌人;标签平滑则是一个明确的「困惑度换准确率」权衡。 - 位置编码(E):学习式与正弦几乎打平(25.7 对 25.8),选正弦的理由是潜在的长度外推能力,而该能力并未被实验验证。
泛化到句法分析
WSJ 第 23 节上的成分句法分析结果(F1):
| 句法分析器 | 训练方式 | F1 |
|---|---|---|
| Vinyals & Kaiser et al. (2014) | 仅 WSJ,判别式 | 88.3 |
| Petrov et al. (2006) | 仅 WSJ,判别式 | 90.4 |
| Zhu et al. (2013) | 仅 WSJ,判别式 | 90.4 |
| Dyer et al. (2016) | 仅 WSJ,判别式 | 91.7 |
Transformer(4 层) | 仅 WSJ,判别式 | 91.3 |
| Zhu et al. (2013) | 半监督 | 91.3 |
| Huang & Harper (2009) | 半监督 | 91.3 |
| McClosky et al. (2006) | 半监督 | 92.1 |
| Vinyals & Kaiser et al. (2014) | 半监督 | 92.1 |
Transformer(4 层) | 半监督 | 92.7 |
| Luong et al. (2015) | 多任务 | 93.0 |
| Dyer et al. (2016) | 生成式 | 93.3 |
Table 4:英文成分句法分析结果。
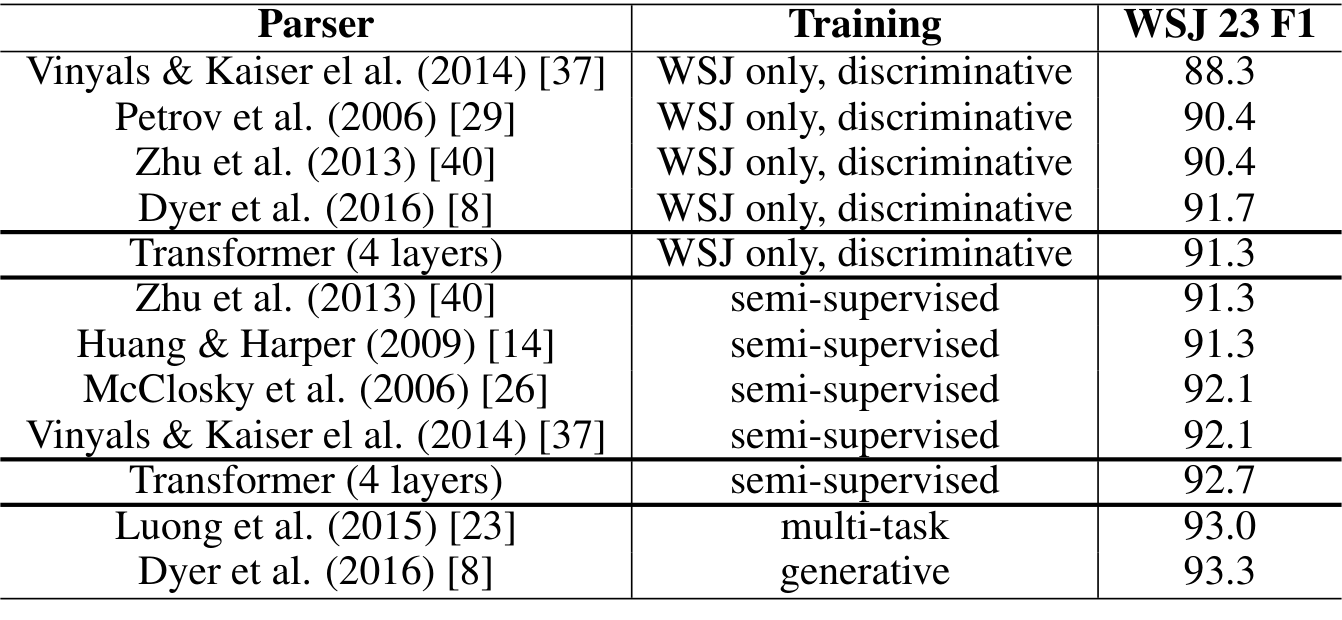 论文原图编号:Table 4。原表截图,与上方重建表格对应。
关键读法:4 层 Transformer 几乎没做任务特定调参,就在两种设置下超过此前绝大多数模型,包括监督式最强的 BerkeleyParser(90.4);唯一稳定压过它的是循环神经网络语法(判别式 91.7、生成式 93.3)。
半监督 92.7 也高于此前全部半监督结果,但仍低于多任务(93.0)与生成式(93.3)两个不同训练范式的结果。
失败或不稳定设置
- 丢弃率为 0 时训练明显过拟合,是全部消融中最差的
BLEU(24.6)。 - 单头与 32 头两个极端都掉点,注意力头数存在倒
U型权衡。 - 键维度压到 16 时质量与困惑度双双恶化,说明查询-键匹配是瓶颈部件,不能随意压缩。
- 标签平滑加大到 0.2 时困惑度显著变差(5.47),收益只体现在准确率侧。
深度分析
为什么有效
这篇论文的结果背后有三条互相支撑的机制链路:
- 常数路径长度降低长程依赖的学习难度。任意输入输出位置之间,自注意力只需 1 次顺序操作即可连通,循环需要 $O(n)$ 次、卷积需要 $O(\log_k n)$ 次堆叠。 信号穿过的路径越短,长程依赖越容易学——这直接对应英德翻译里对远距离词序调整的建模能力。
- 去掉顺序约束释放并行度,让算力预算更多花在有效容量上。同样的墙钟时间里,纯注意力架构可以做更多训练步数,这解释了为什么基准模型的
FLOPs低却仍然赢。 - 多头 + 缩放保证注意力机制本身可用。缩放防止
softmax饱和,多头防止平均化抹掉多峰依赖,消融中单头掉 0.9BLEU、小 $d_k$ 掉 0.7BLEU是这两条链路最直接的证据。
注意力还带来一个潜在收益:可解释性。 附录的可视化显示不同头学到了明显不同的行为,有的头跟随长距离动词依赖,有的头呈现共指消解的模式,有的头对句法结构敏感。 这类证据是案例级的可视化观察,支持「头之间存在分工」这个弱主张,但不构成系统性的可解释性证明。
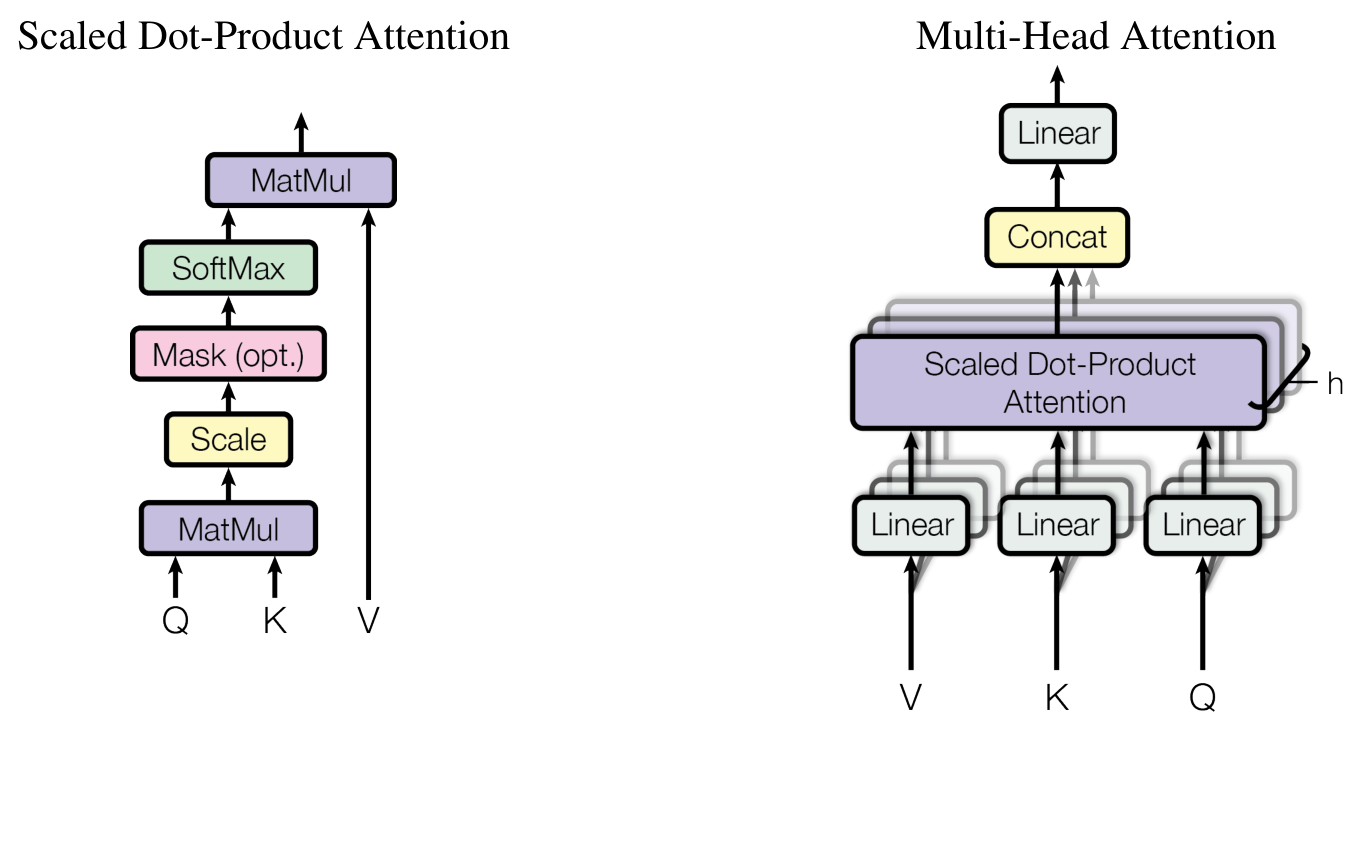 论文原图编号:Fig. 2。左侧为缩放点积注意力数据流、右侧为多头并行投影-拼接结构,对应「缩放」与「多头」两条机制链路。
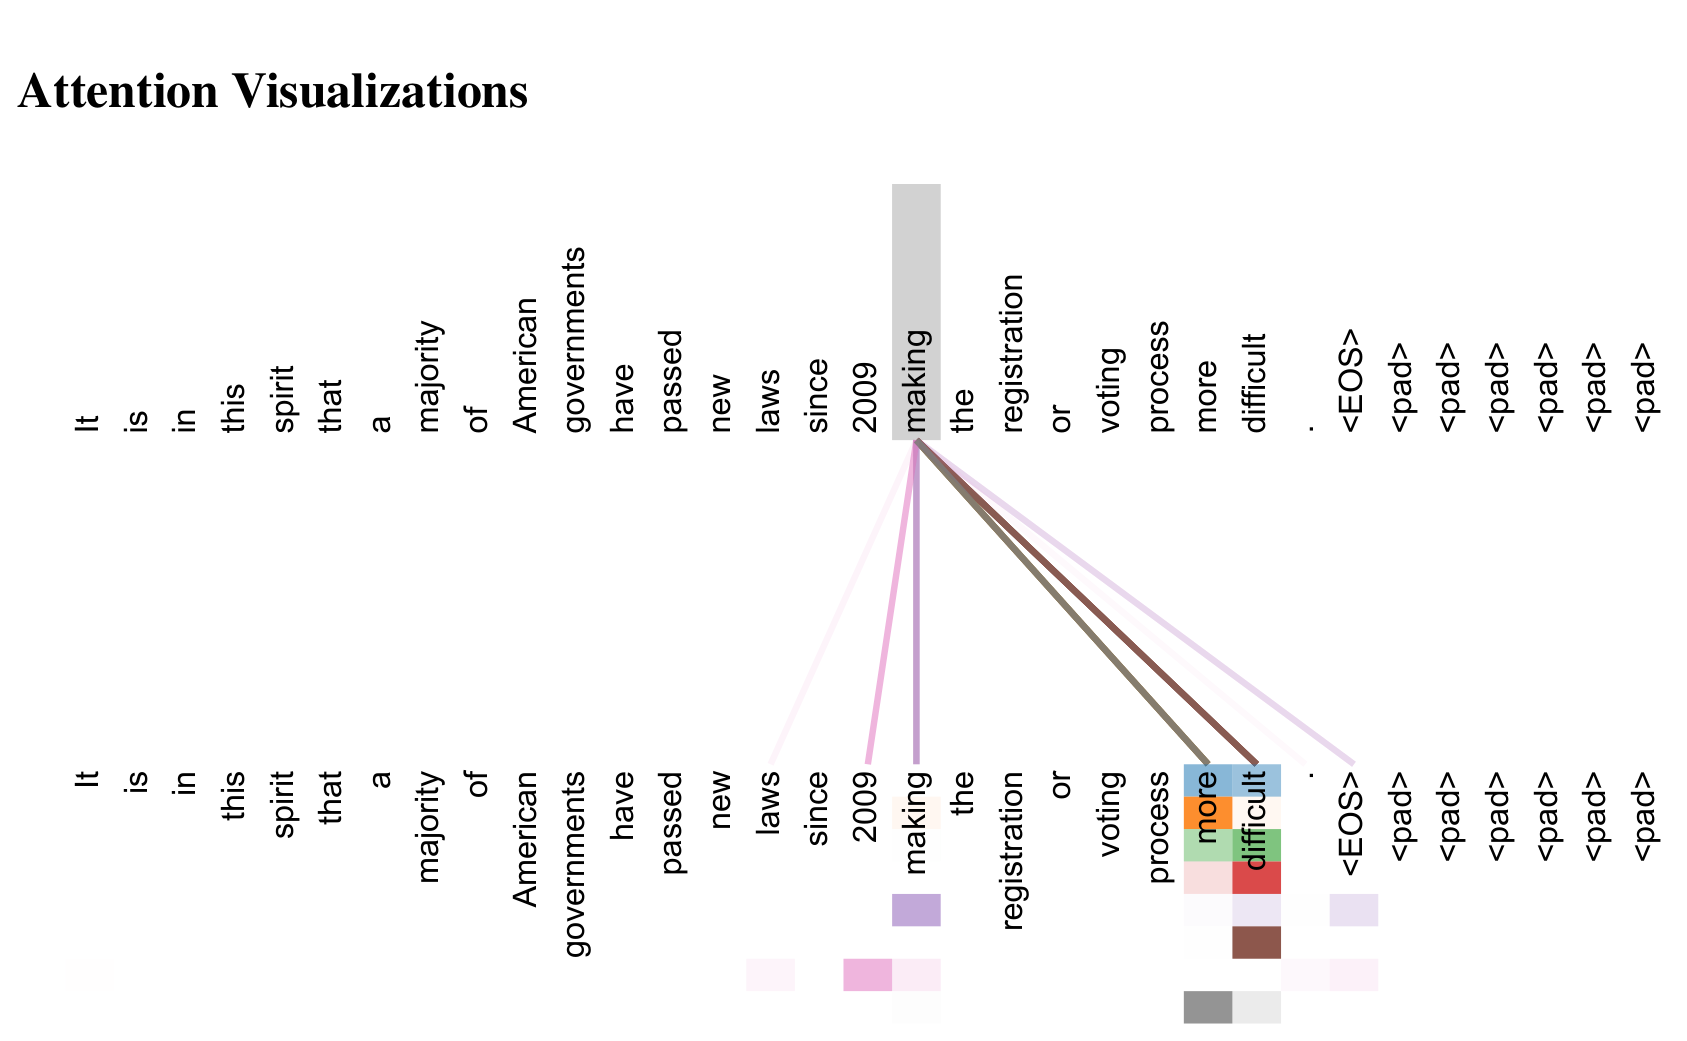 论文原图编号:Fig. 3。编码器自注意力第 5 层跨越词位捕捉长距离依赖的实例,支撑常数路径长度的主张。
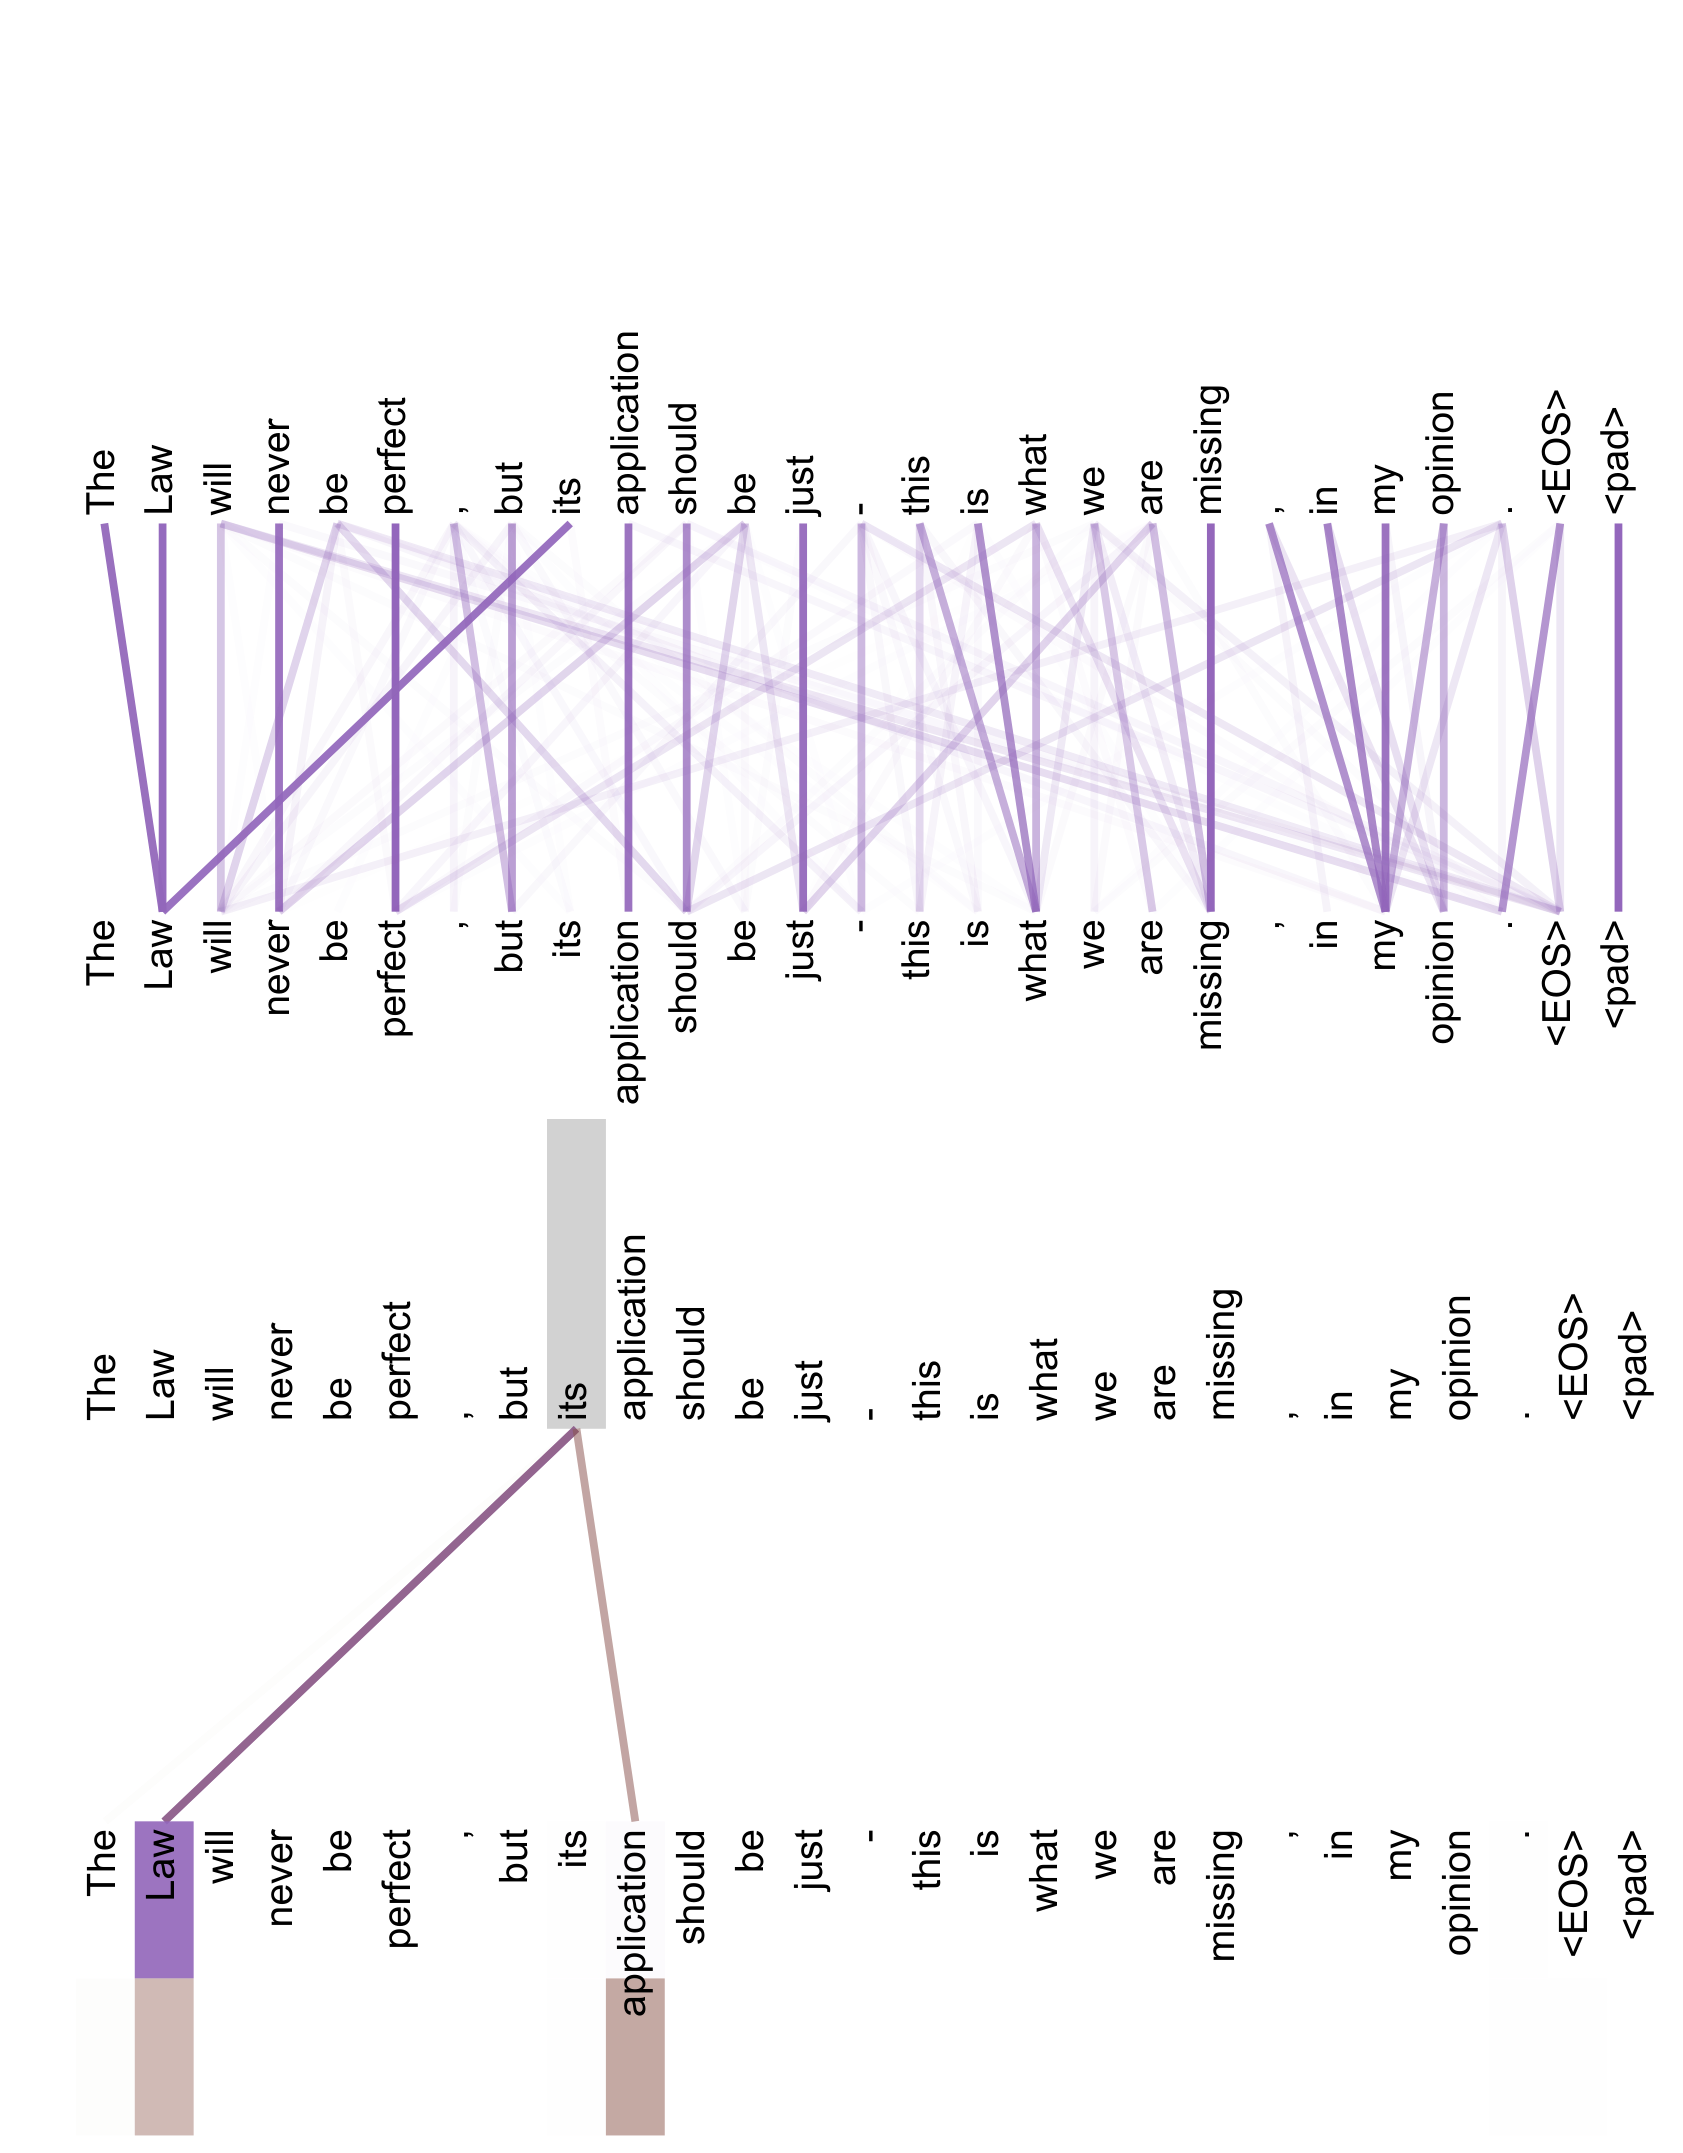 论文原图编号:Fig. 4。第 5 层两个头对代词的注意力分布,呈现共指消解行为。
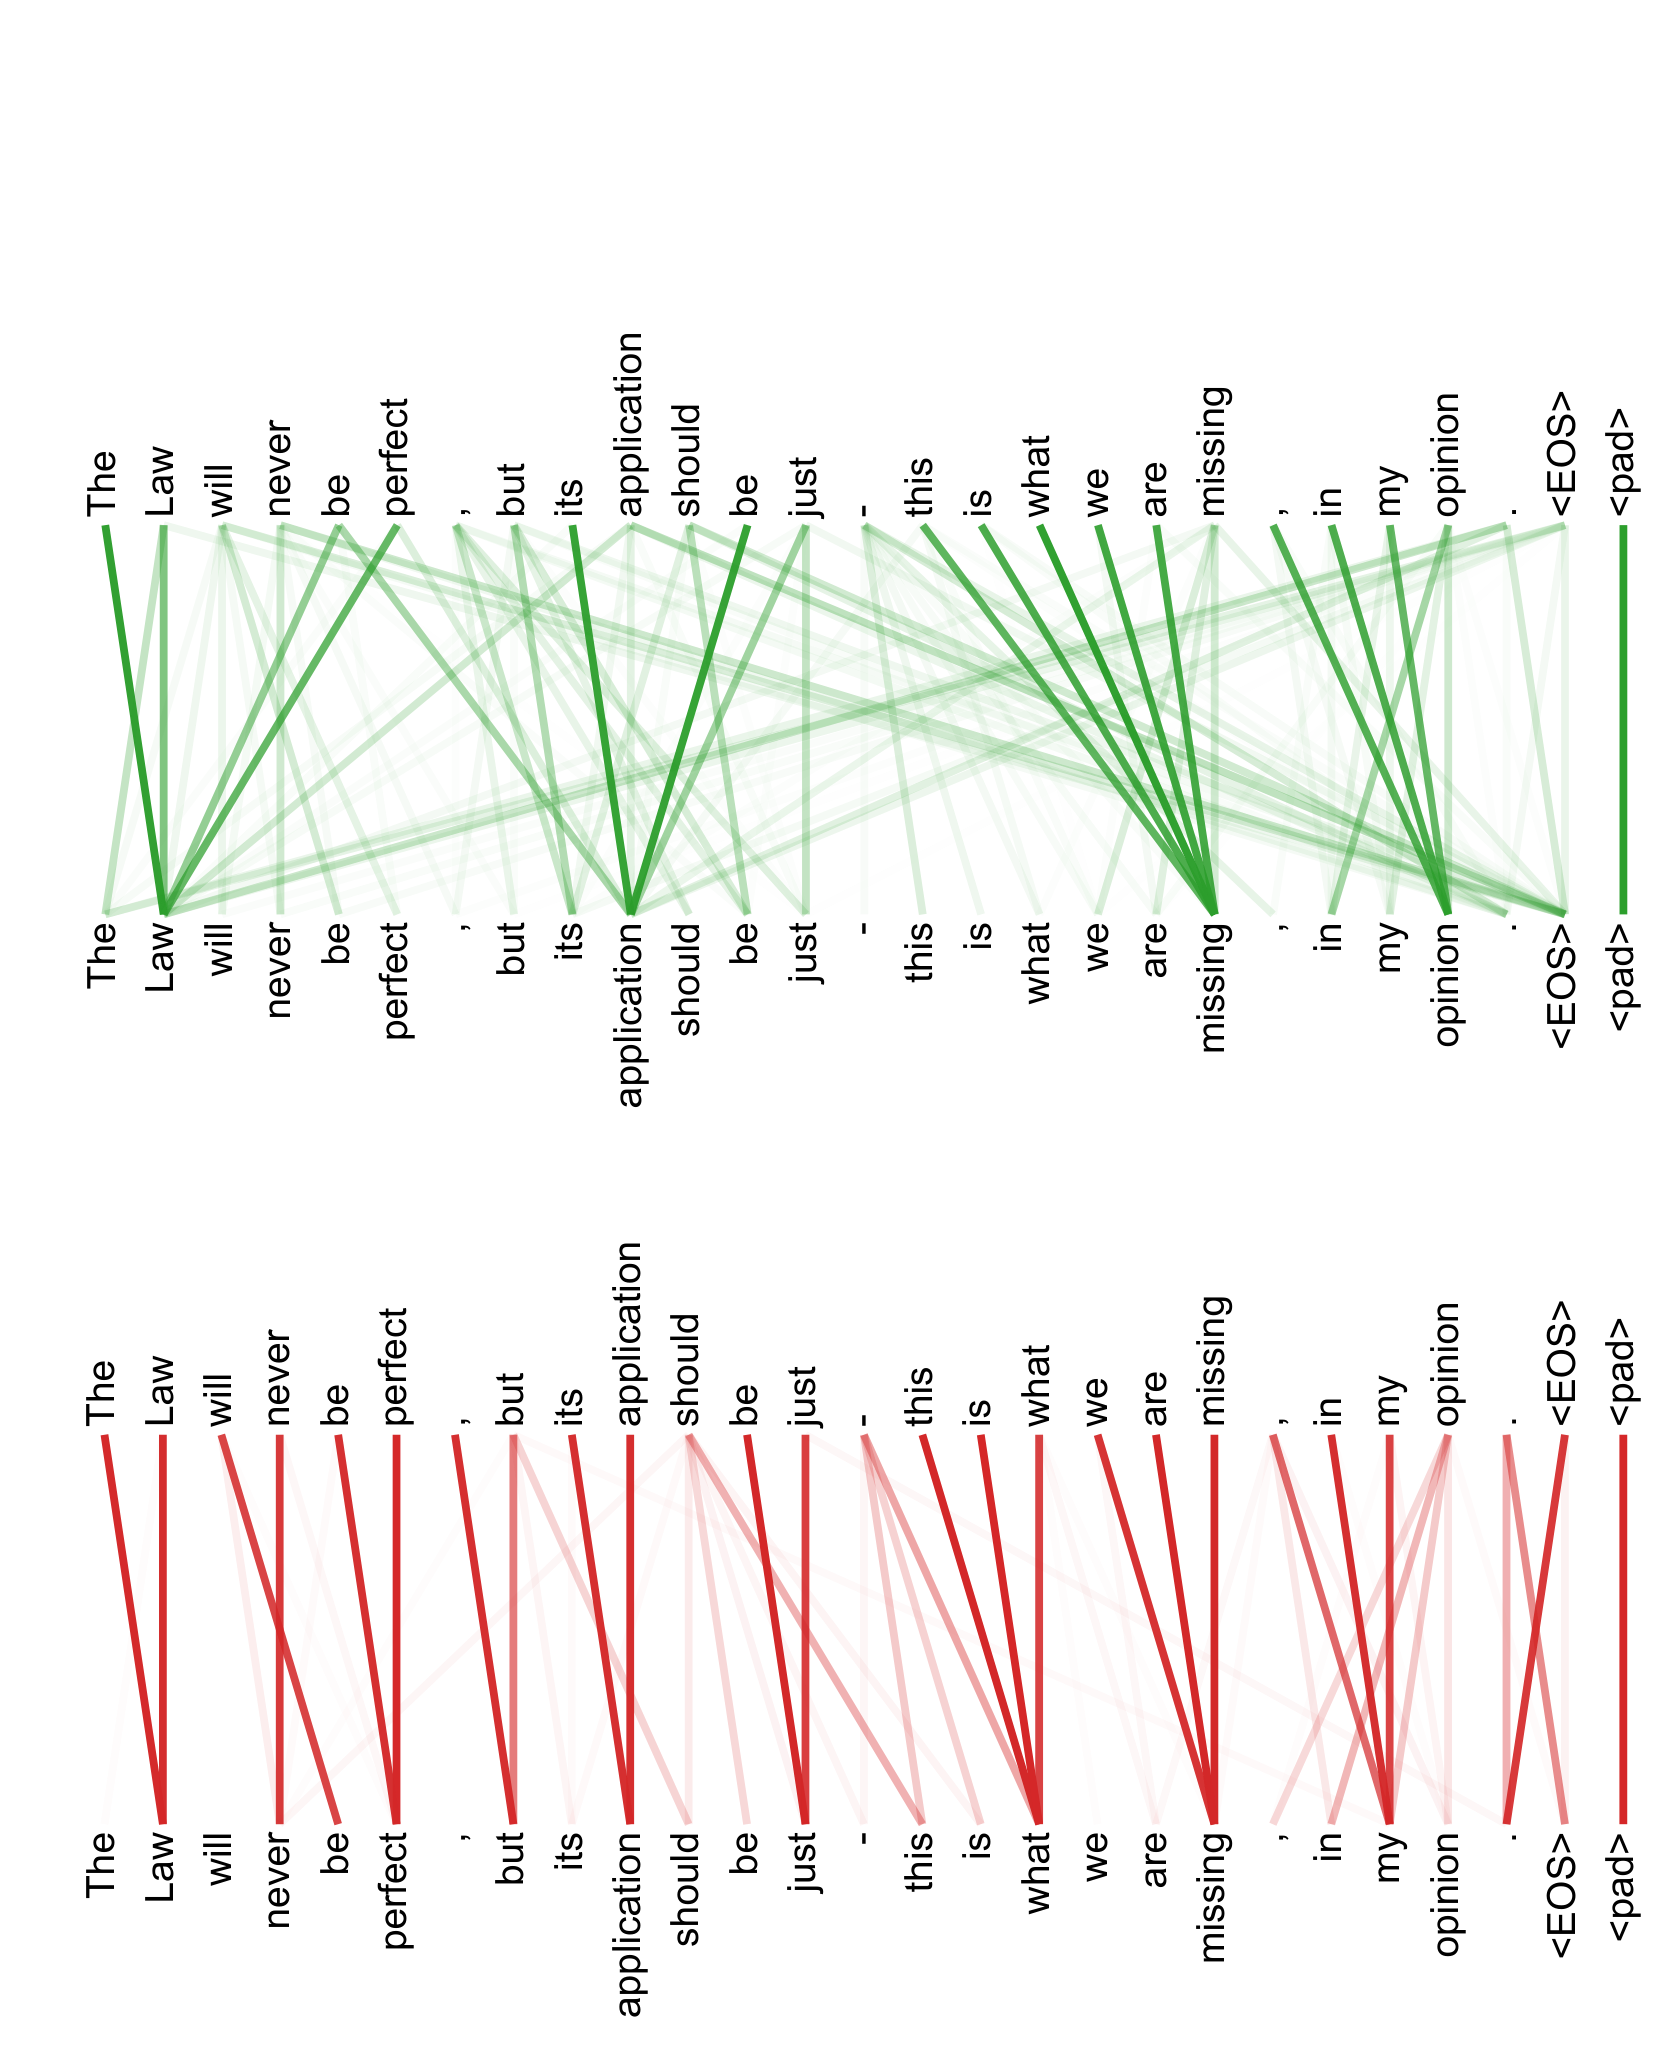 论文原图编号:Fig. 5。两个头分别关注句法结构不同侧面的例子。
复杂度与扩展性
下表省略大 O 记号,只列关键因子:
| 层类型 | 每层复杂度 | 顺序操作数 | 最大路径长度 |
|---|---|---|---|
| 自注意力 | $n^2 d$ | $1$ | $1$ |
| 循环 | $n d^2$ | $n$ | $n$ |
| 卷积 | $k n d^2$ | $1$ | $\log_k n$ |
| 自注意力(受限) | $r n d$ | $1$ | $n/r$ |
Table 1:不同层类型的复杂度、顺序操作数与最大路径长度对比($n$ 为序列长度,$d$ 为表示维度,$k$ 为卷积核宽,$r$ 为受限注意力的邻域大小)。
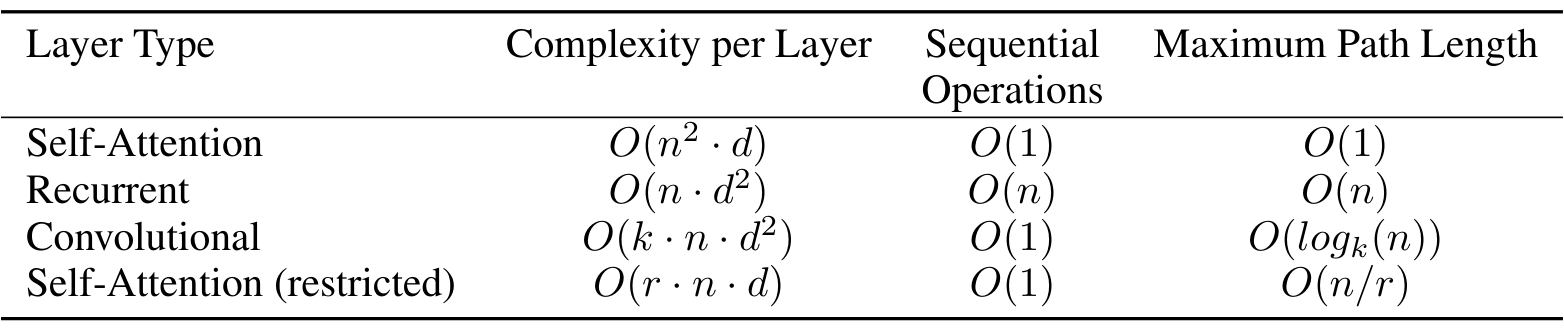 论文原图编号:Table 1。原表截图(原候选为空白条,已按修正边界重裁),内容与上方重建表格一致。
读这张表要注意三点:
- 自注意力赢在 $n<d$ 的区间。 逐层复杂度上自注意力是 $n^2 d$、循环是 $n d^2$,序列长度 $n$ 小于表示维度 $d$ 时自注意力更便宜。 句级翻译词表化后通常满足该条件,但长文档、音频这类 $n$ 很大的场景结论会反转,$n^2$ 项会成为瓶颈。
- 可分离卷积是卷积侧的强基线。核宽取 $n$ 时,可分离卷积的复杂度恰好等于「一层自注意力 + 一层逐位置前馈」的组合,即本文架构的单层开销。
- 论文提出的补救方案(受限注意力,只关注半径 $r$ 的邻域,路径长度退化为 $O(n/r)$)在本文中没有实验,属于给出思路、留给未来验证的部分。
复现注意点
- 检查点平均是结果的一部分:基准取最后 5 个、大模型取最后 20 个检查点平均,不做这步
BLEU会有可见损失;Table 3的消融恰恰没有做平均,所以 dev 数字不能与主结果直接比较。 FLOPs是估算而非实测:口径是「训练时长 ×GPU数量 × 持续单精度算力」,其中算力按P1009.5TFLOPS等固定值估计;跨论文比较成本时要检查对方的估算口径是否一致。- 词表口径影响
BLEU可比性:英德用 37K 共享BPE、英法用 32K 词级切分,与其他论文的分词口径不同会带来零点几的系统性差异。 - 两处文本不一致需要留意:英法大模型成绩摘要写 41.8、正文 6.1 写 41.0;英法大模型的丢弃率是 0.1(不是英德大模型的 0.3)。
- 复现最小配置:宽度 $d_{model}=512$、前馈内层 $d_{ff}=2048$、深度 $N=6$。
头数 $h=8$、每头维度 $d_k=d_v=64$。
训练侧:
Adam(0.9,0.98,$10^{-9}$)、$warmup=4000$、标签平滑 0.1、dropout0.1。 按 25000+25000 词元组批,训练 10 万步。
局限
论文用证据证明了的:
- 在
WMT 2014英德与英法两个特定数据集、特定词表口径下,翻译质量与训练成本的优势成立。 - 头数、键维度、规模、
dropout、标签平滑这几个组件在英德开发集上的作用方向明确(Table 3)。 - 在英文成分句法分析这一种非翻译任务上,架构无需太多调参即可工作。
论文没有证明、但容易被引用成结论的:
- 长度外推能力:正弦位置编码「可能」外推到更长序列,论文没有任何训练长度之外的系统性实验,学习式与正弦在实验里只是打平。
- 模态泛化:把架构推广到图像、音频、视频被明确列为未来工作,本文一个实验都没有。
- 解码效率:并行化收益在训练侧;解码仍是自回归顺序生成,推理延迟与吞吐论文从未测量,「生成不够顺序」也被作者自己列为待解决问题。
- 架构收益的归因边界:与基线的对比跨越不同年份、不同词表、不同训练预算,
FLOPs又是估算值,因此「纯注意力优于循环/卷积」的结论严格来说限于所比配置,不能读作对所有规模、所有算力预算的普遍定理。 - 可解释性主张:注意力头的可视化是轶事级案例,不构成「学到句法/语义结构」的系统性证明。
- 受限注意力与长序列方案:只给了复杂度分析和设想,没有实验支撑。
此外还有一个论文自陈的机制代价:注意力加权平均会降低有效分辨率,多头只是缓解而没有消除这个问题。
我的笔记
这篇论文值得长期保留的不是 28.4 这个数字,而是它把「结构选择 → 复杂度与路径长度 → 实验结果」这条论证链完整示范了一遍。写架构论文或做架构选型时可以直接套用它的三个评估维度:每层复杂度、顺序操作数、最大路径长度。
可复用的工程判断:
- 拿到序列建模任务,
Transformer可以作为默认强起点,尤其当输出受结构约束、输出长于输入时(句法分析实验就是这种情况)。 - 中等规模数据上,正则化的优先级高于加宽加深:
dropout归零的伤害(-1.2BLEU)大于大多数结构改动。 - 复现这类工作时,检查点平均、束搜索宽度、长度惩罚、学习率升温步数这四个「非架构」细节对最终分数的影响,未必小于架构本身。
- 如果输入序列很长,先算清楚 $n^2$ 项的代价,再决定要不要上受限注意力或稀疏化方案。
留在待办里的问题(论文没有回答):
- 去掉 $1/\sqrt{d_k}$ 缩放会退化到什么程度?缺一个独立消融。
- 受限注意力的邻域 $r$ 取多大能保住全局路径优势?
- 正弦编码的长度外推是真实存在还是一厢情愿?
- 自回归解码的延迟劣势有多大,非自回归化能补回多少?
- 低资源语言对上,纯注意力的优势是否还在?
引用
- Vaswani et al. (2017). Attention Is All You Need.
- Bahdanau et al. (2014). Neural machine translation by jointly learning to align and translate.
- Gehring et al. (2017). Convolutional sequence to sequence learning.
- Wu et al. (2016). Google’s neural machine translation system: bridging the gap between human and machine translation.
- Shazeer et al. (2017). Outrageously large neural networks: the sparsely-gated mixture-of-experts layer.
- Kalchbrenner et al. (2017). Neural machine translation in linear time.
- Kaiser and Bengio (2016). Can active memory replace attention?.
- Dyer et al. (2016). Recurrent neural network grammars.
- Vinyals et al. (2015). Grammar as a foreign language.
- Petrov et al. (2006). Learning accurate, compact, and interpretable tree annotation.
- Ba et al. (2016). Layer normalization.
- He et al. (2016). Deep residual learning for image recognition.
- Kingma and Ba (2015). Adam: a method for stochastic optimization.
- Szegedy et al. (2016). Rethinking the inception architecture for computer vision.