这篇手册跟着的是北京大学 DCML 组的《DataFlow 系列图文教程》的实操过程。DataFlow 是 OpenDCAI 团队开源的数据治理系统,专门对付 PDF 文档、纯文本、爬虫数据这类嘈杂的低质量数据:经过修正、扩增、评估、过滤四类算子,产出能直接拿去训练的高质量数据集,再用预训练、SFT 或 RL 去提升模型在通用领域(推理、检索)和垂直领域(医疗、金融、法律)的表现。
- 图文教程(飞书 Wiki):https://wcny4qa9krto.feishu.cn/wiki/I9tbw2qnBi0lEakmmAGclTysnFd
- GitHub 仓库:https://github.com/OpenDCAI/DataFlow
- 中文文档:https://opendcai.github.io/DataFlow-Doc/zh/
- B 站视频教程:https://space.bilibili.com/3546929239689711
这次实操是租用腾讯云单卡 V100 服务器东京节点上完成:1.1 走完全链路——环境搭建、LoRA 微调、对话验证、量化测评;1.2 上 GPU 版,独立跑 KBCleaning 流水线。机器是腾讯云 Ubuntu 22.04,1 × Tesla V100-SXM2-32GB(驱动 535 / CUDA 12.2),10 核 / 38GB 内存,磁盘空闲 60GB 以上;pip 走腾讯云镜像,HuggingFace 可直连(约 10MB/s)。
整个过程由服务器上的 pi-coding-agent(1.2.0,glm-5.3)执行,我负责确认和关键决策(KBC/VQA 的选择、显存参数的取舍)。规矩是 agent 每步先列出要跑的命令和影响,我点头之后才执行,文中截图大多能看到这个交互。踩过的坑都写进了对应步骤,照着做能少走弯路。
前置:pi-agent 安装与任务下发
先准备好 agent 环境:装 pi、配模型、下发任务。
| |
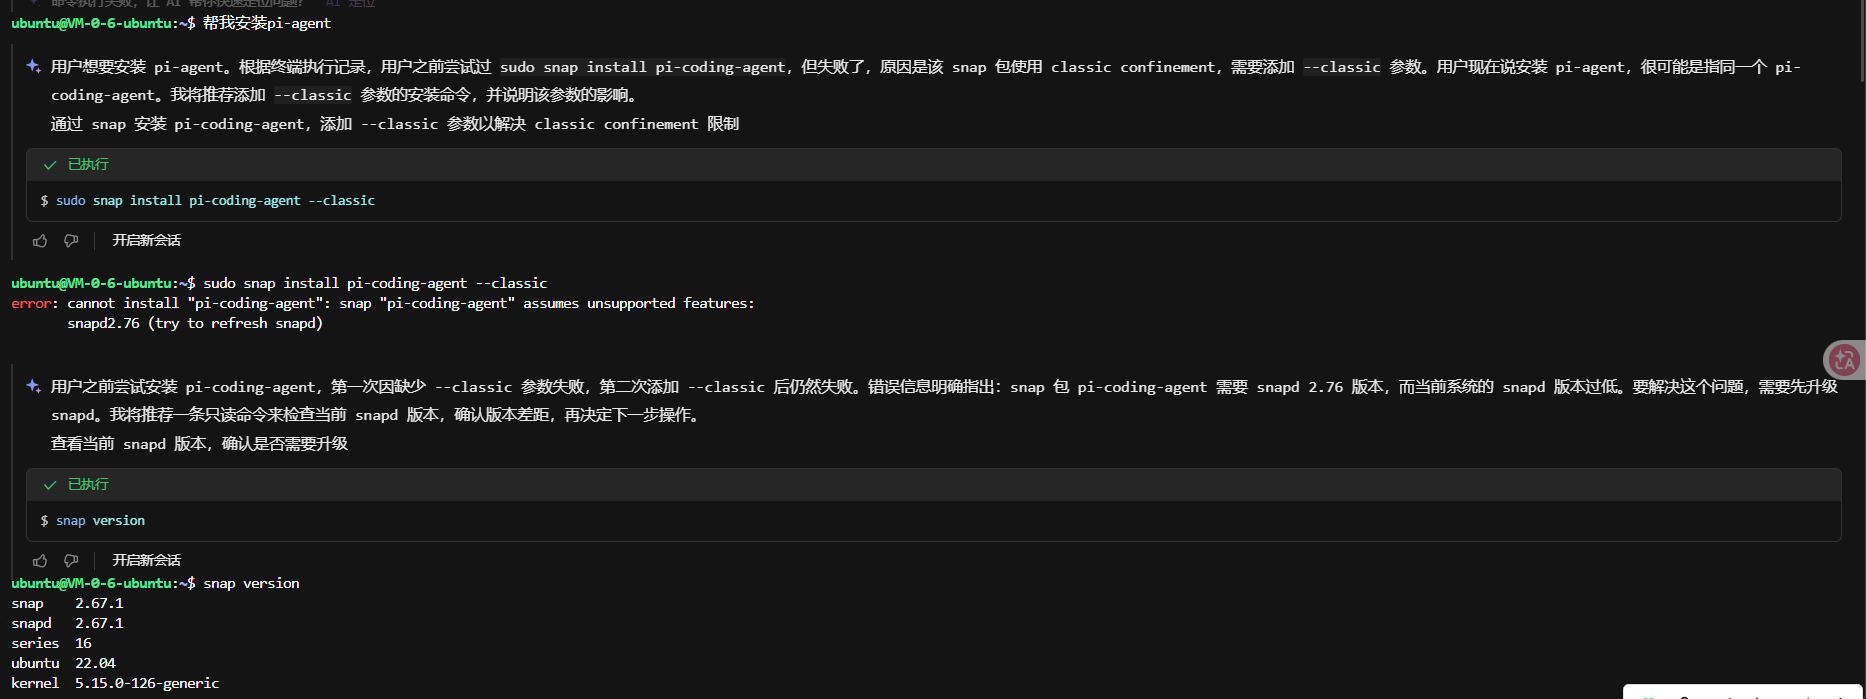
安装 pi-coding-agent。snap 安装必须带 --classic;本机 snapd 是 2.67.1,低于 snap 包要求的 2.76,第一次装直接失败:
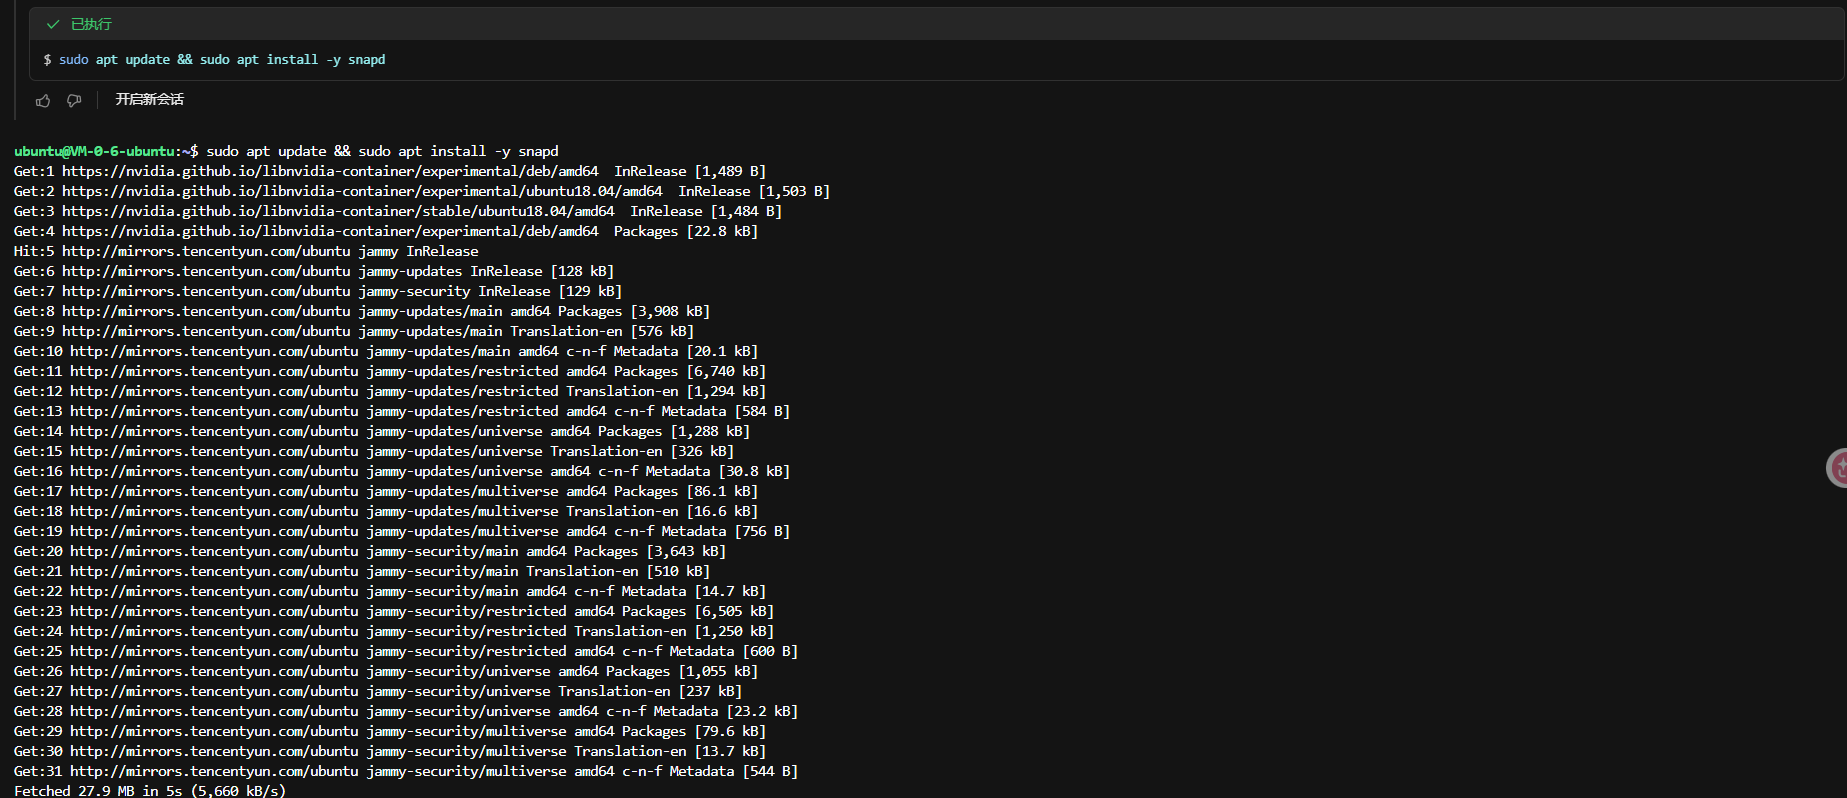
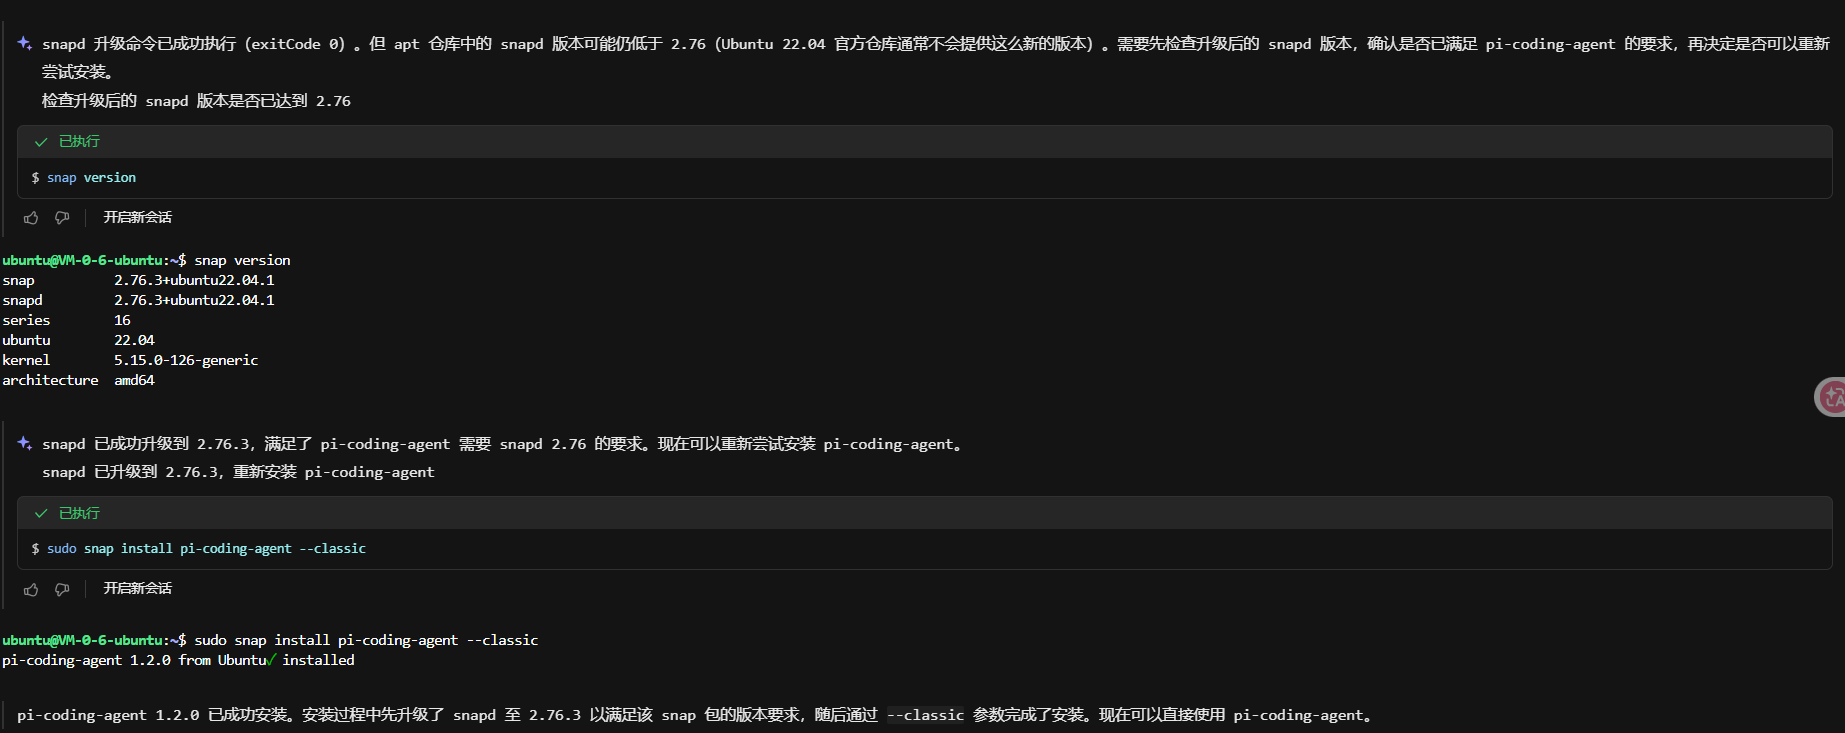
升级系统组件把 snapd 带到 2.76.3,重装就过了(pi-coding-agent 1.2.0 from Ubuntu installed):
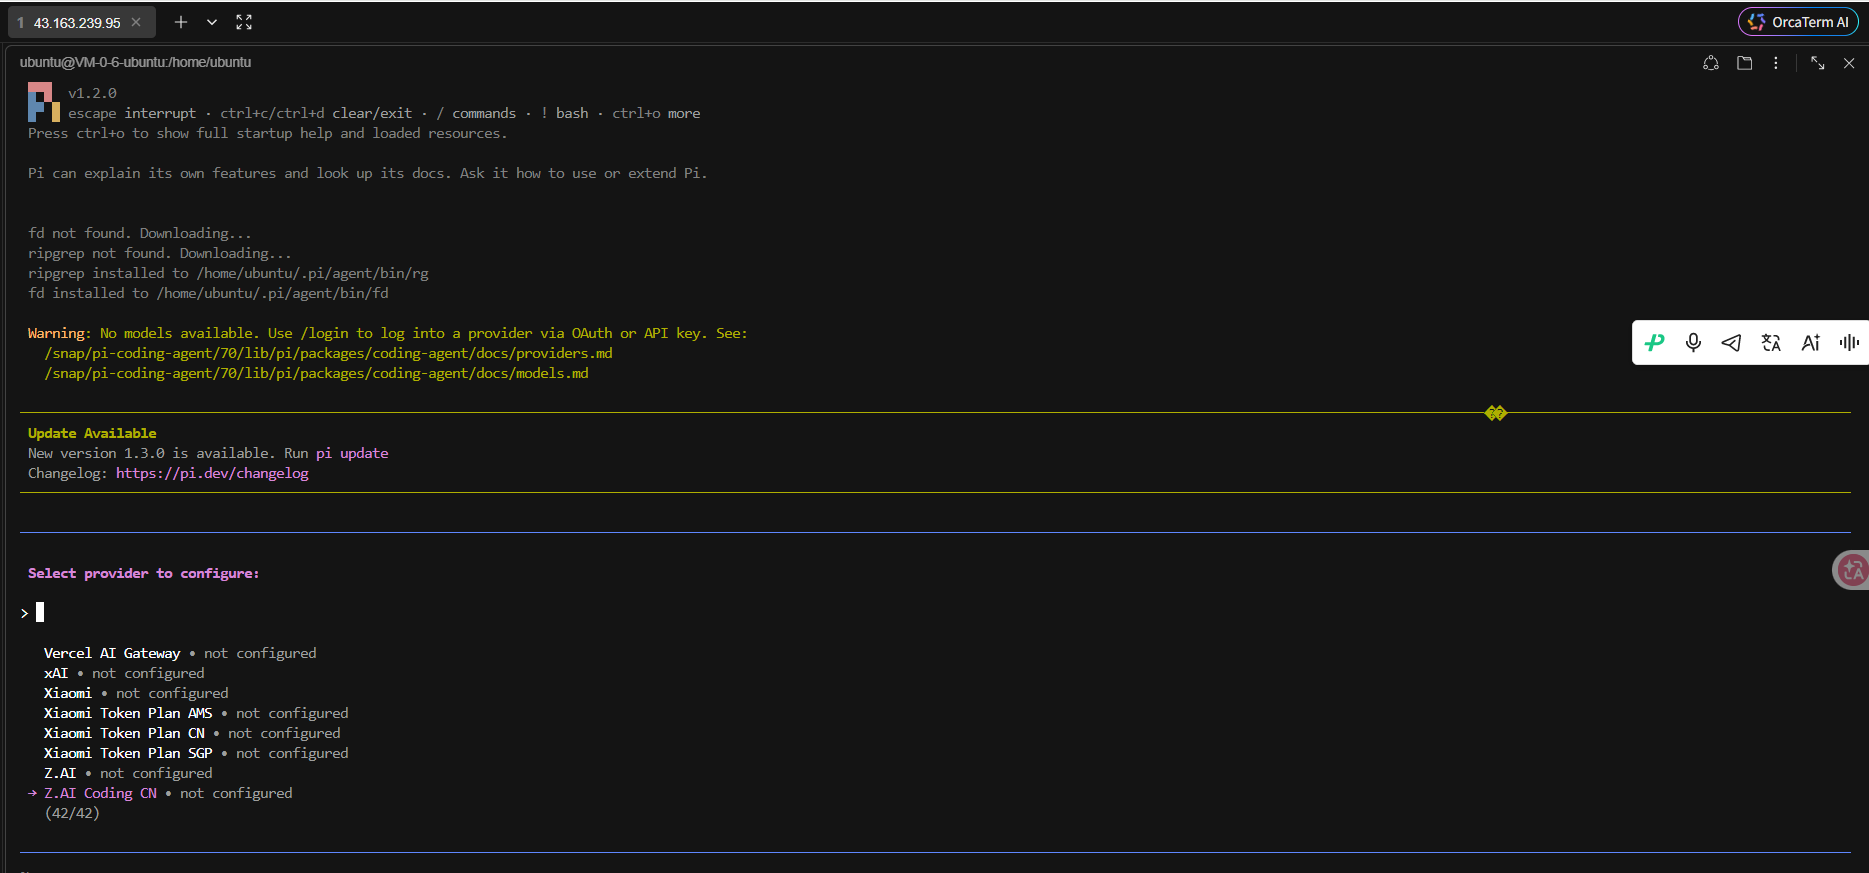
首次启动与模型配置。首次启动提示 No model available,需要选 provider、配 model 和 token。我选的 Z.AI Coding CN · glm-5.3,凭证写入 ~/.pi/agent/auth.json:
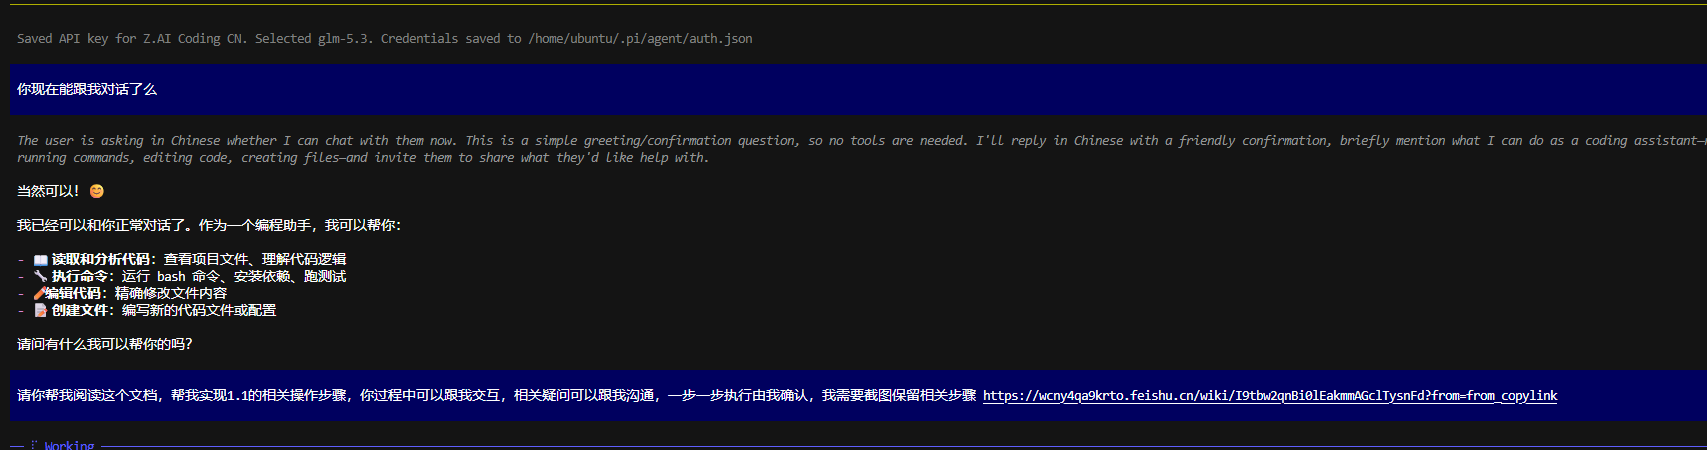
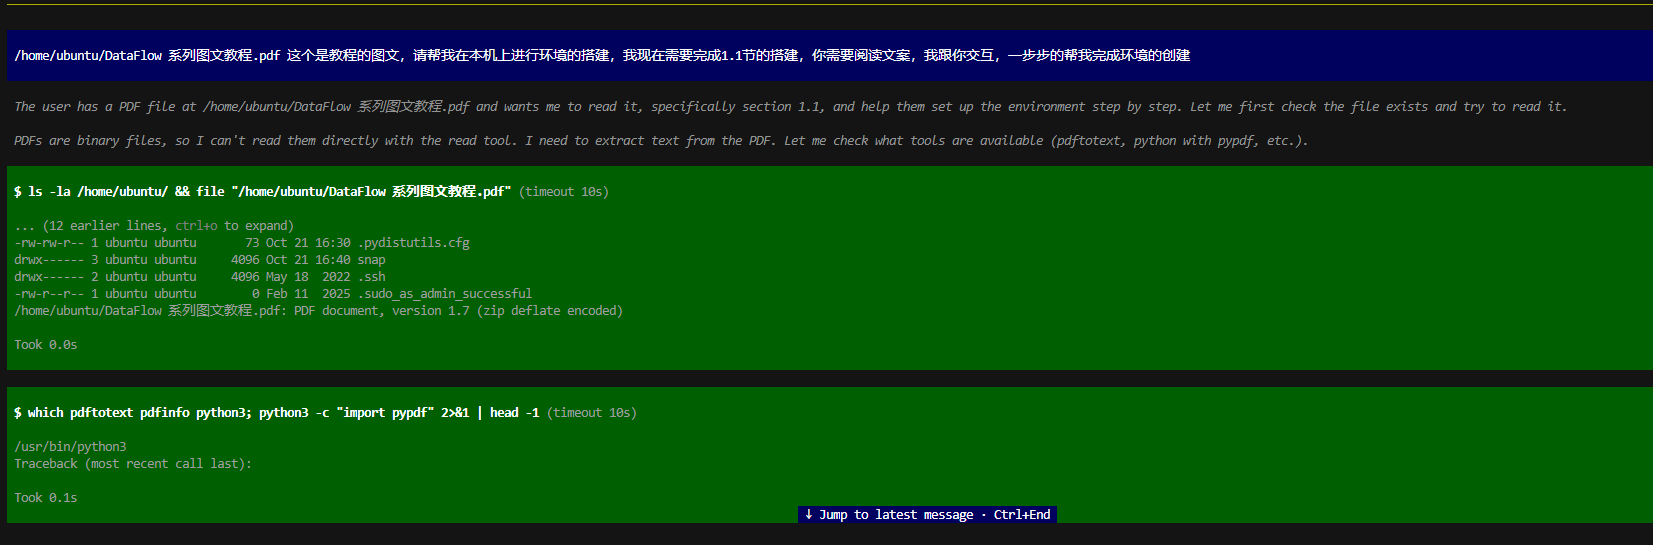
下发任务。配置完成后先跟 pi 过了一遍能力边界(读文档 / 执行命令 / 写代码 / 建文件),然后把任务交给它:读服务器上的《DataFlow 系列图文教程.pdf》,完成 1.1 节搭建。同时约定好——每个步骤执行前先跟我确认。
整体流程
| |
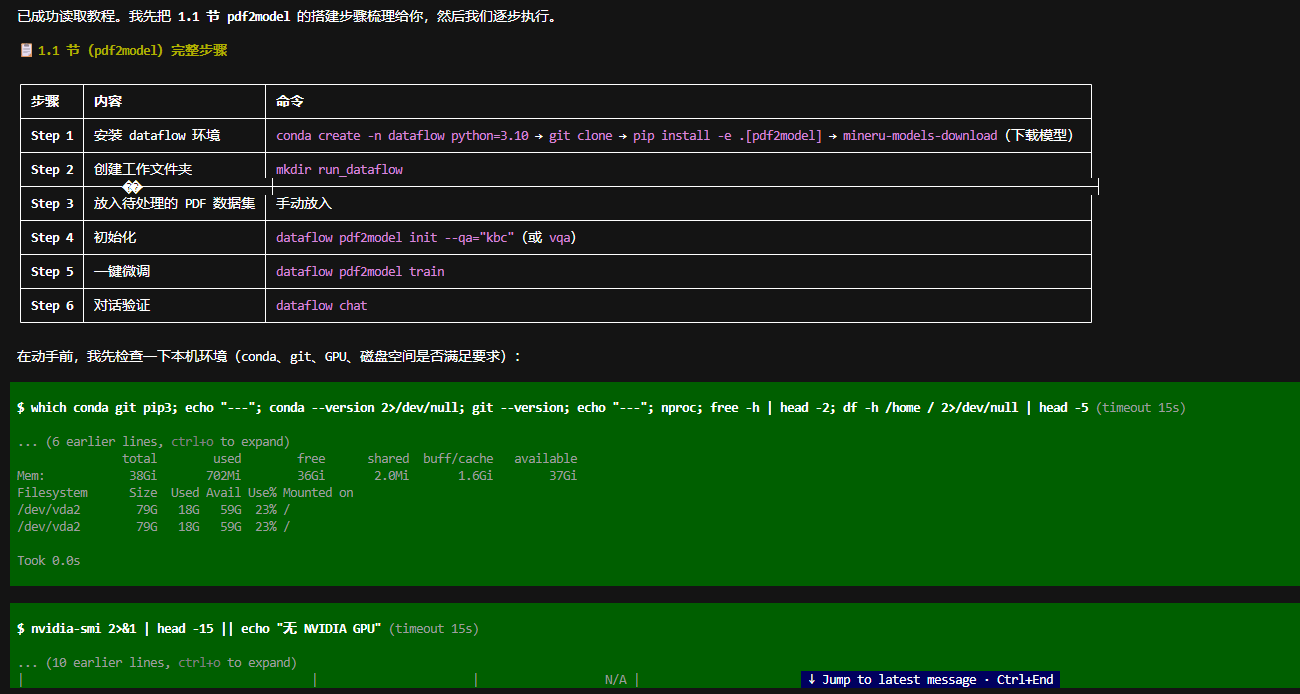
1.1 节的具体步骤是 pi 从 PDF 教程里提取并复述的,见前置篇末尾和 Step 0 的配图。
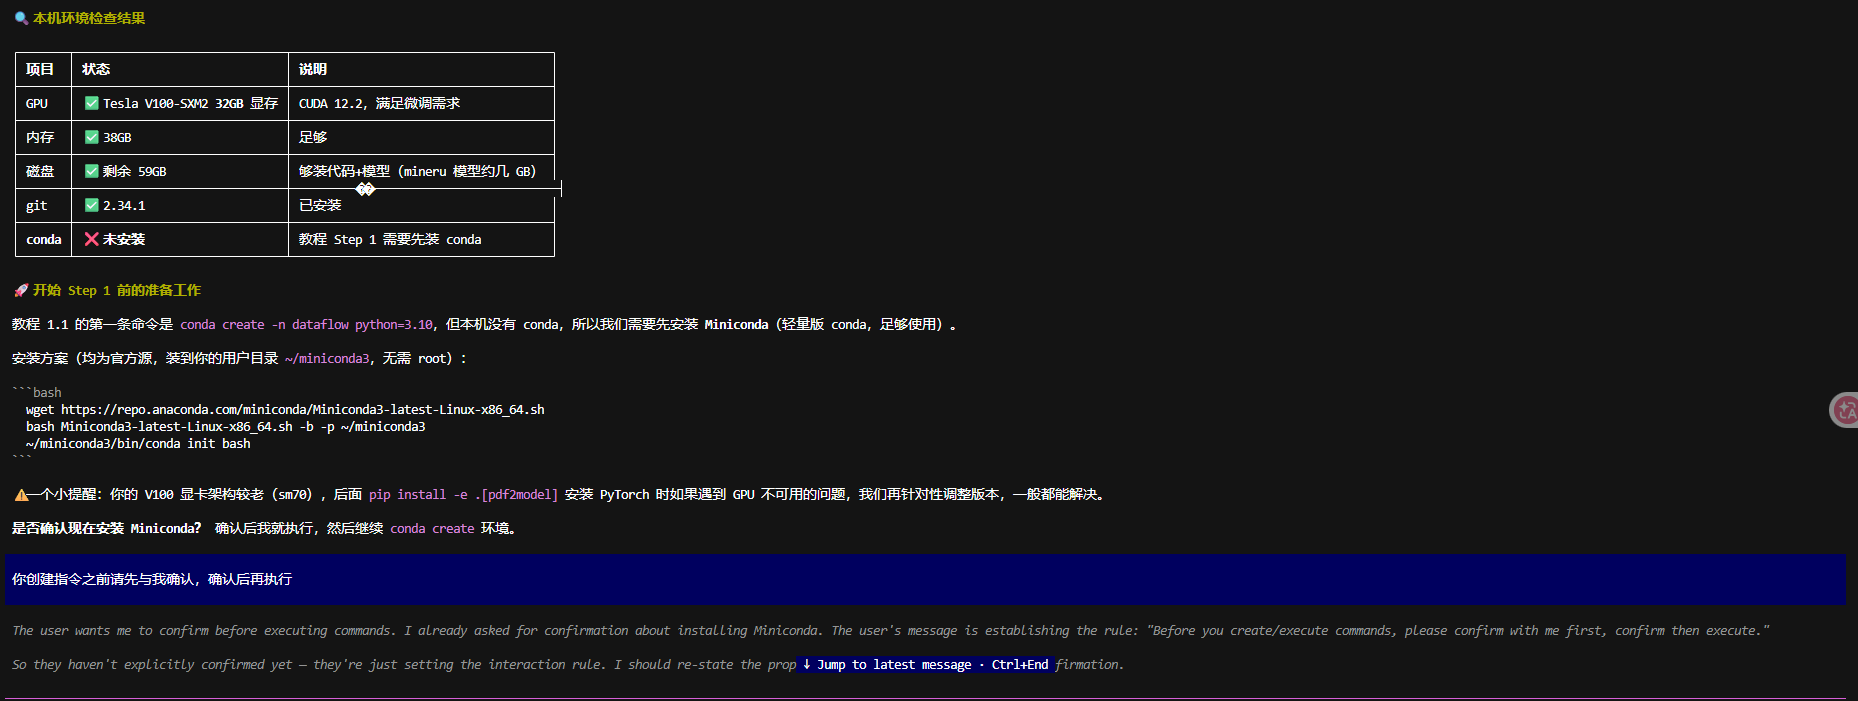
Step 0 环境检查与安装 Miniconda
| |
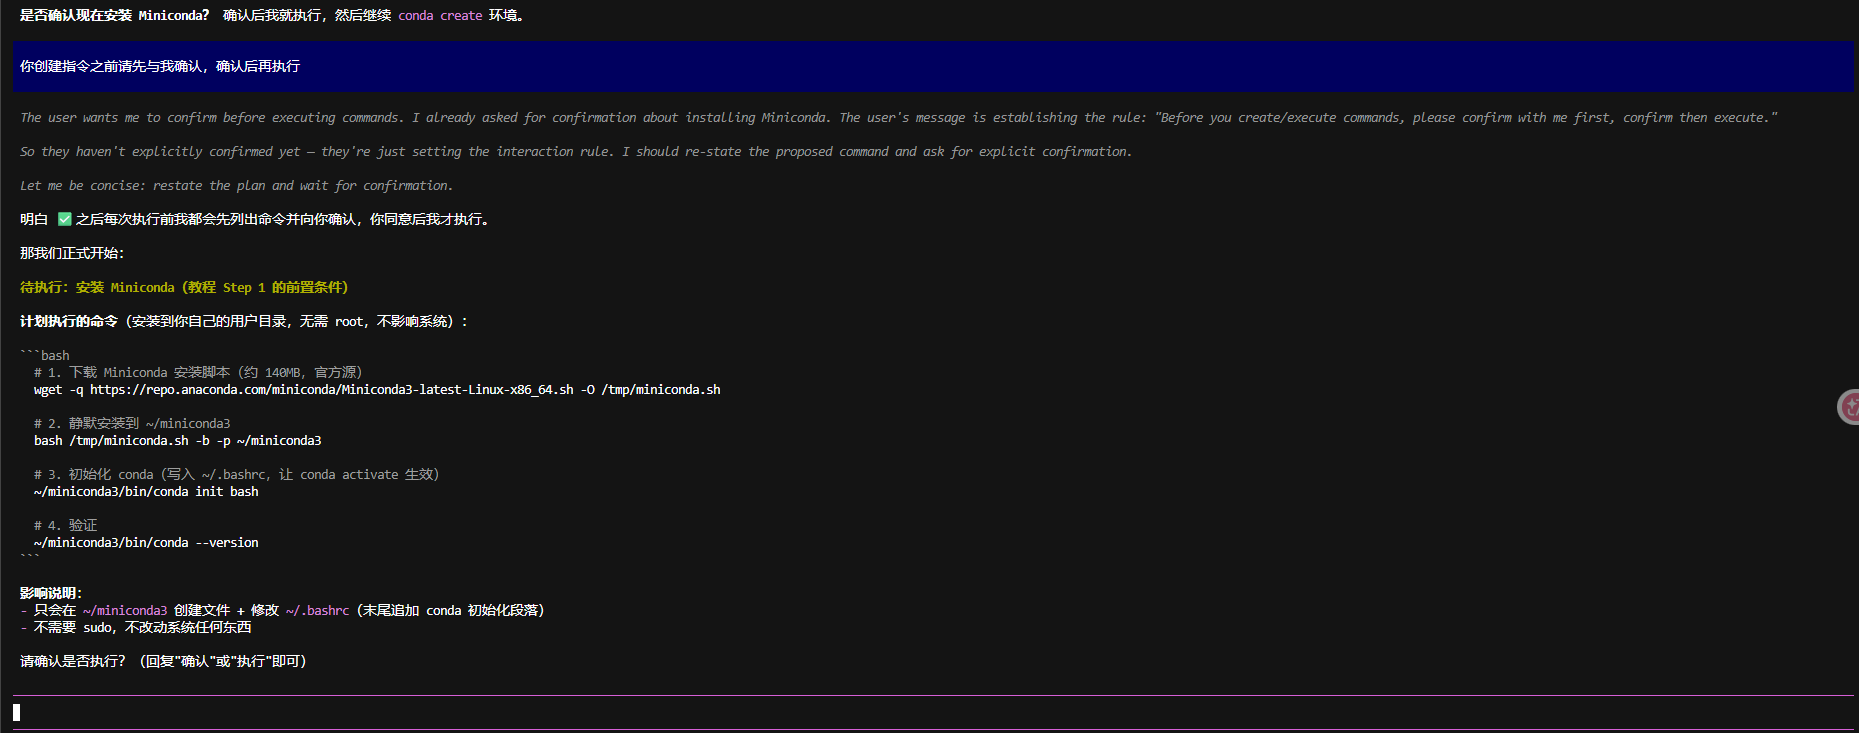
安装 Miniconda(装在用户目录,不需要 root):
| |
注意:新版 conda(26.x)第一次
conda create会被 TOS 条款拦住,先跑一遍接受命令:
1 2conda tos accept --override-channels --channel https://repo.anaconda.com/pkgs/main conda tos accept --override-channels --channel https://repo.anaconda.com/pkgs/r
Step 1 创建环境、克隆仓库、安装依赖
| |
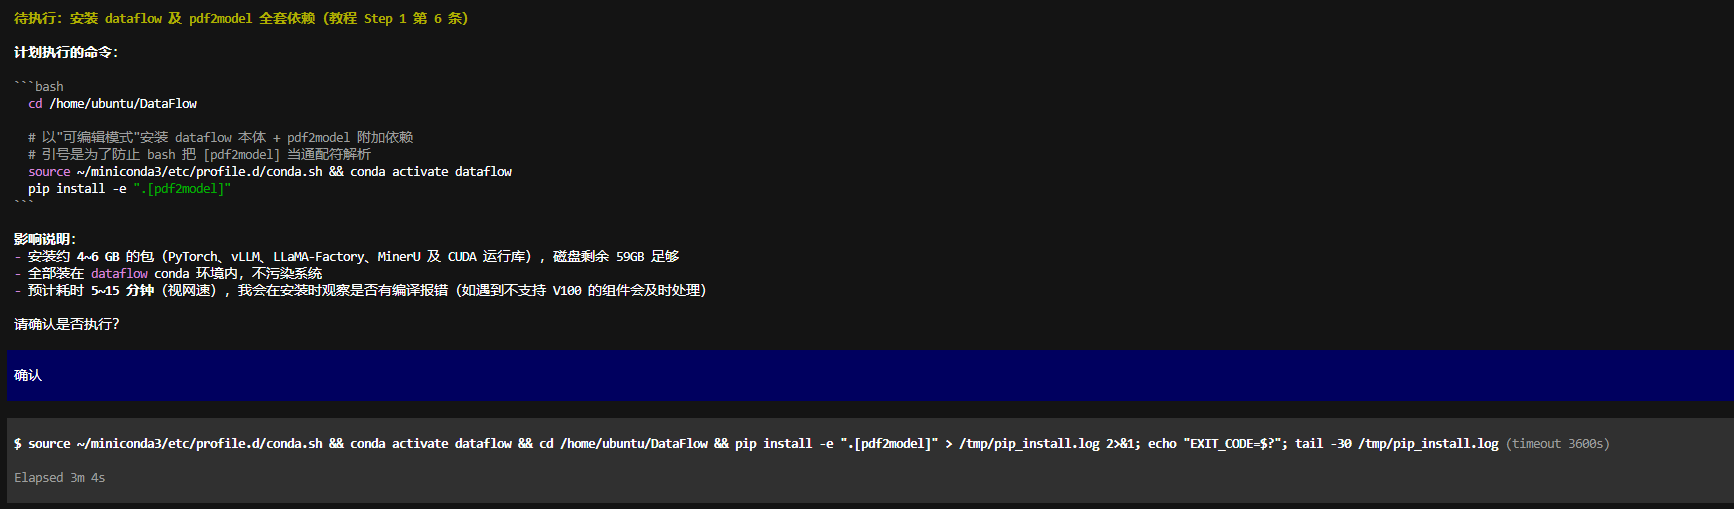
安装量约 4~6GB,大概 10 分钟。关键组件版本:
| 包 | 版本 | 说明 |
|---|---|---|
| open-dataflow | 1.0.11 | 可编辑模式安装 |
| torch | 2.7.0+cu126 | V100 可直接使用(驱动向下兼容) |
| vllm | 0.9.1 | 依赖约束 <0.9.2 恰好是最后支持 V100 的版本 |
| llamafactory | 0.9.3 | LoRA 微调框架 |
| mineru | 2.7.6 | PDF 解析 |
装完验证:
| |
V100 服务器提前装好图形库:无界面机器缺 opencv 依赖的系统图形库,后面 Flash 解析阶段会报
ImportError: libGL.so.1,提前装上(需要 sudo):
1sudo apt-get install -y libgl1 libglib2.0-0
Miniconda 26.9.3 装好并写入 ~/.bashrc 后,创建 dataflow 环境并拉取源码:
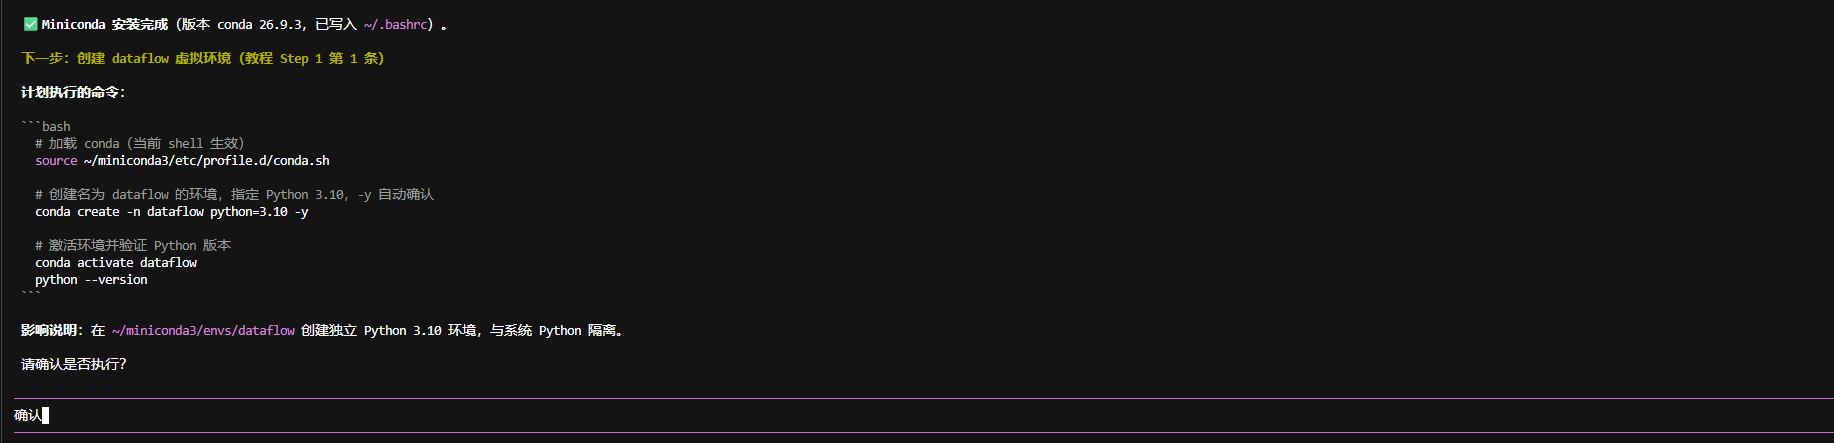
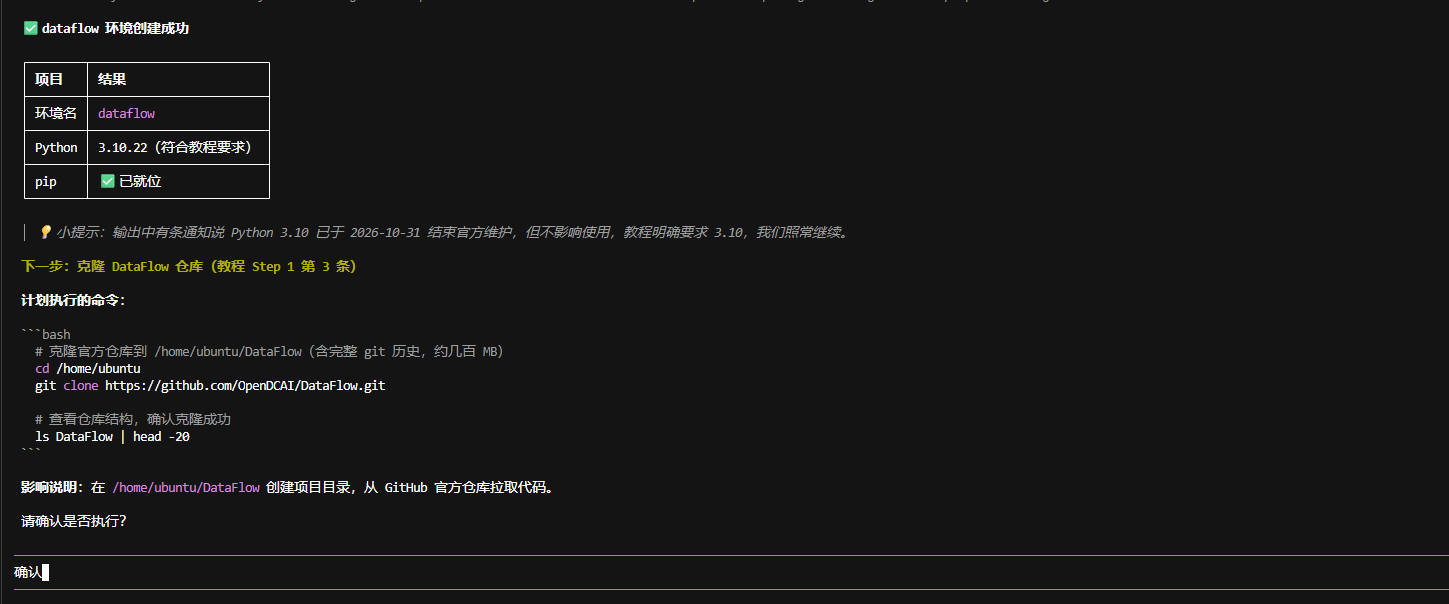
然后 pip 安装 pdf2model 全套依赖(同样是先列计划、确认后执行):
Step 2 模型准备(MinerU 解析模型)
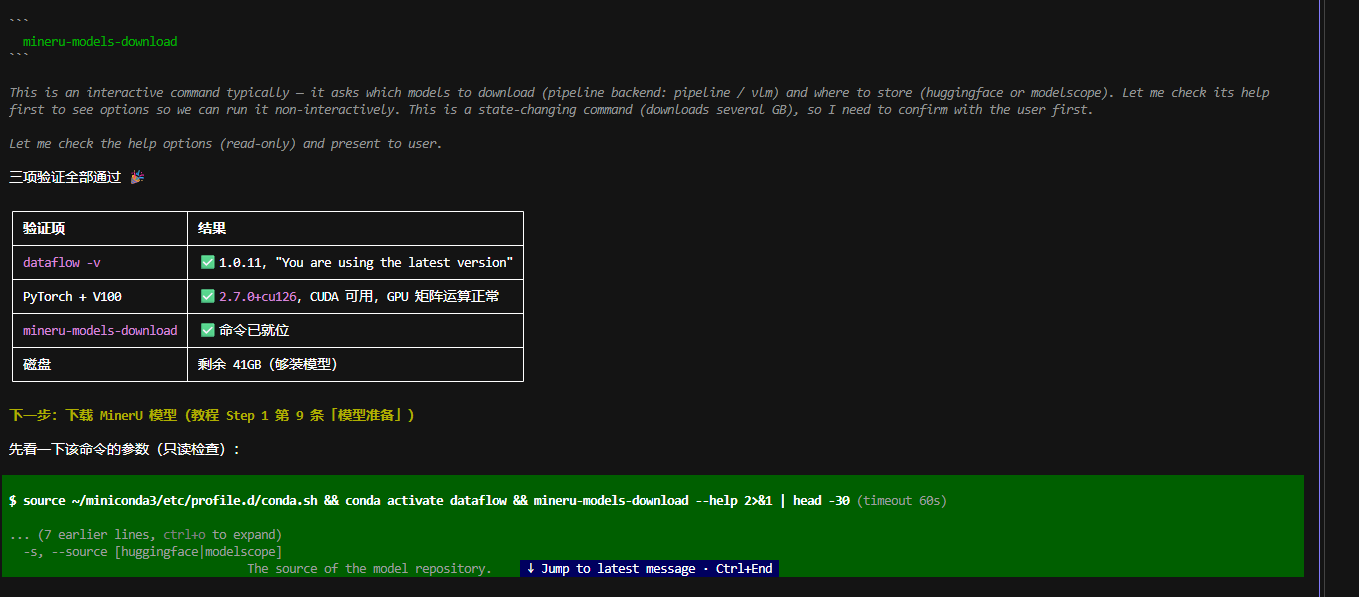
1.1 节的 KBC/VQA 两种模式都用 pipeline 系列 10 个模型(版面/公式/表格/OCR 等,约 3~4GB);vlm 系列是 1.10 节 PDF2VQA 才用的,本节用不到。
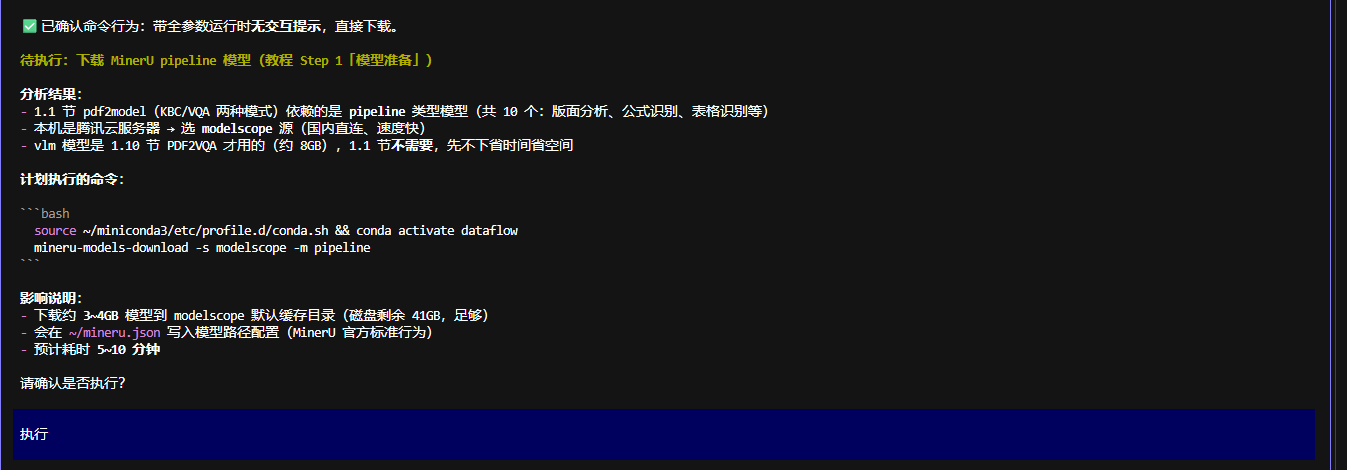
依赖装完先做了三项验证(见下图),再启动 MinerU 模型下载。这一步走了弯路:先用的 modelscope 源,限速严重,后来切到 huggingface 才正常。下面的命令是最终推荐配置。
| |
- 带全参数运行则没有交互提示,下载完自动生成
~/mineru.json配置 - 中断了重跑即可:已完成的模型自动跳过,支持续传
坑:modelscope 源限速严重。单线程只有约 167KB/s,预估 30 分钟起步,我让 pi 换成 HF 源重下并后台续传,速度直接快了一个数量级:
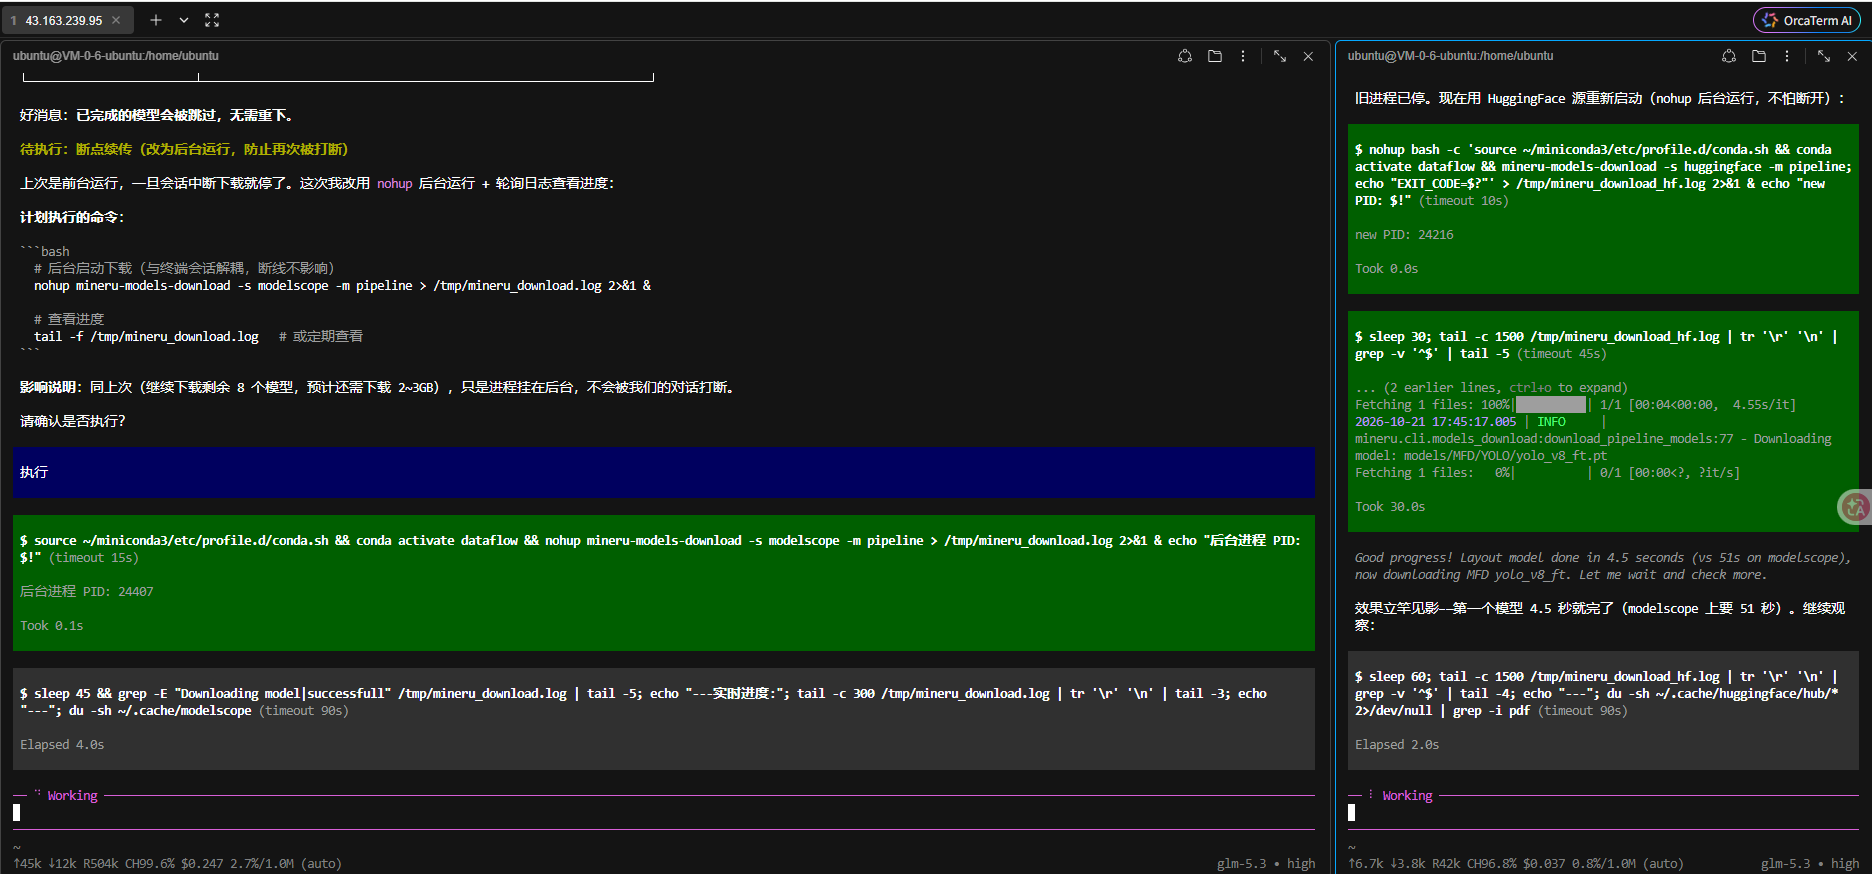
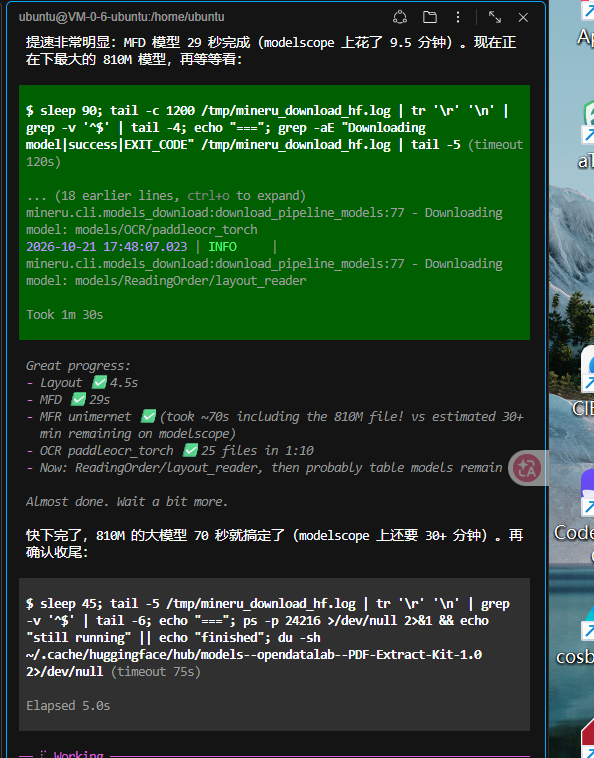
等下载的空档,pi 自己规划了并行任务:模型在后台下着,同时把不依赖下载的工作目录先建好,日志里能看到下载持续推进:
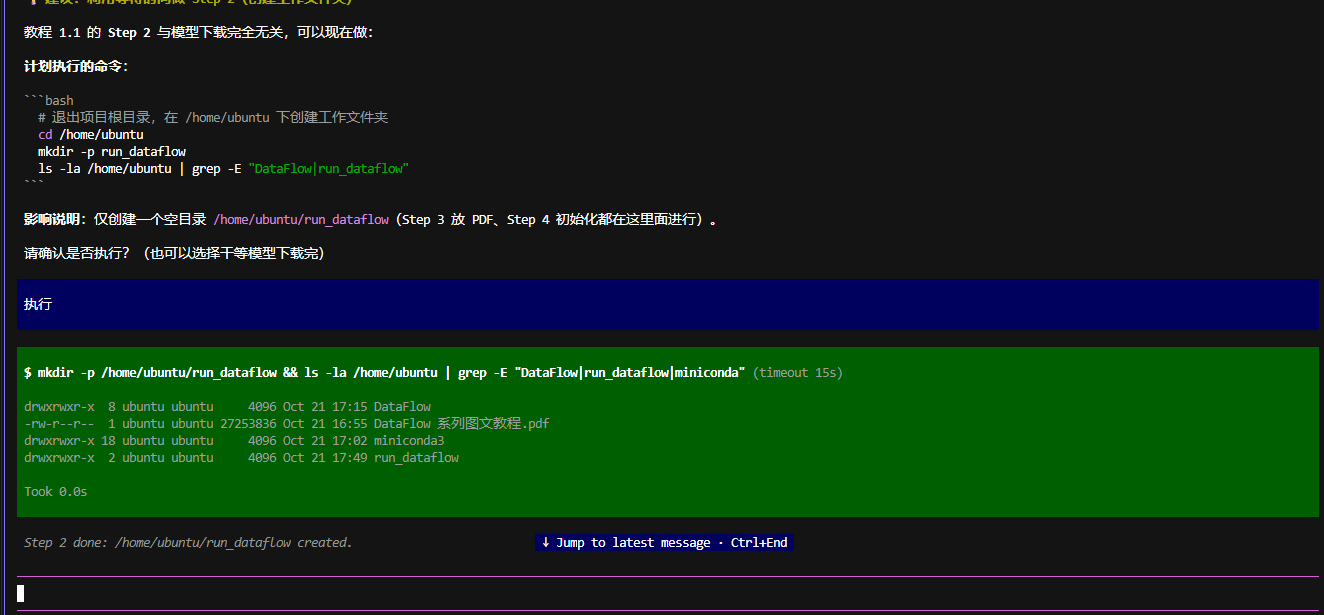
Step 3 创建工作目录
| |
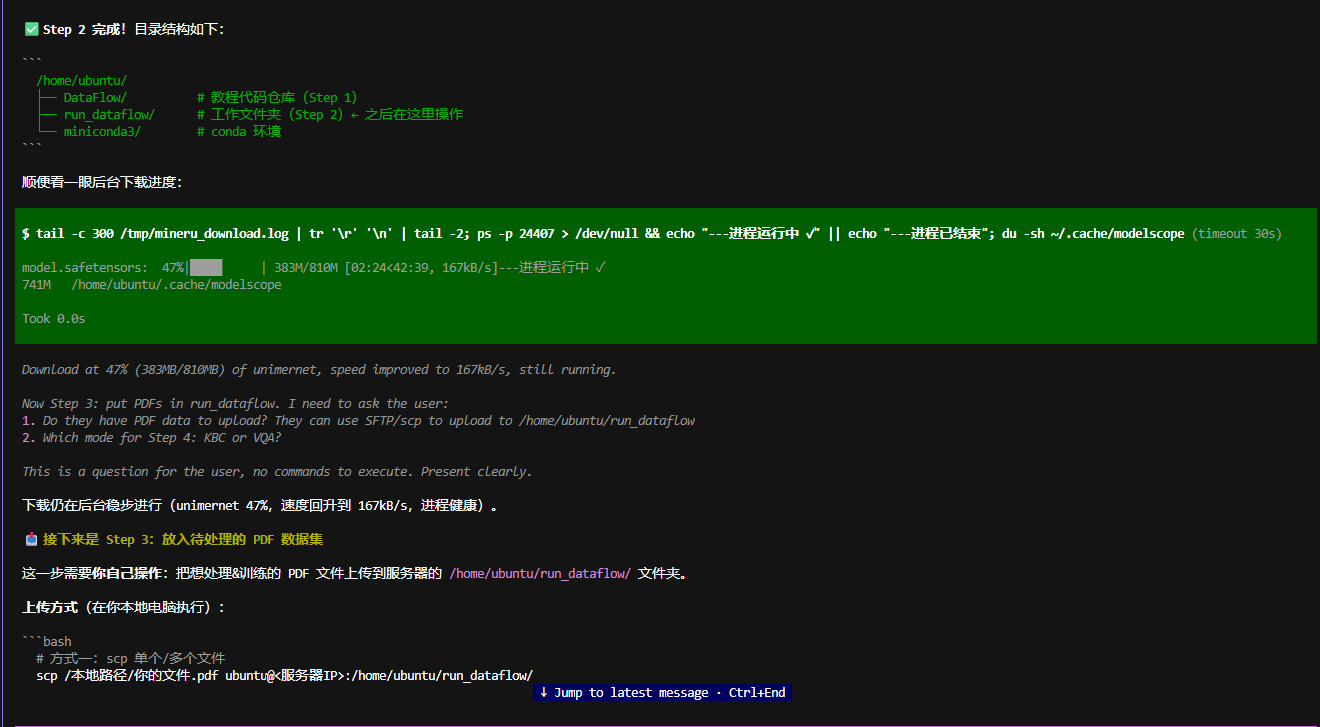
Step 4 上传待处理数据(PDF)
在本地电脑执行:
| |
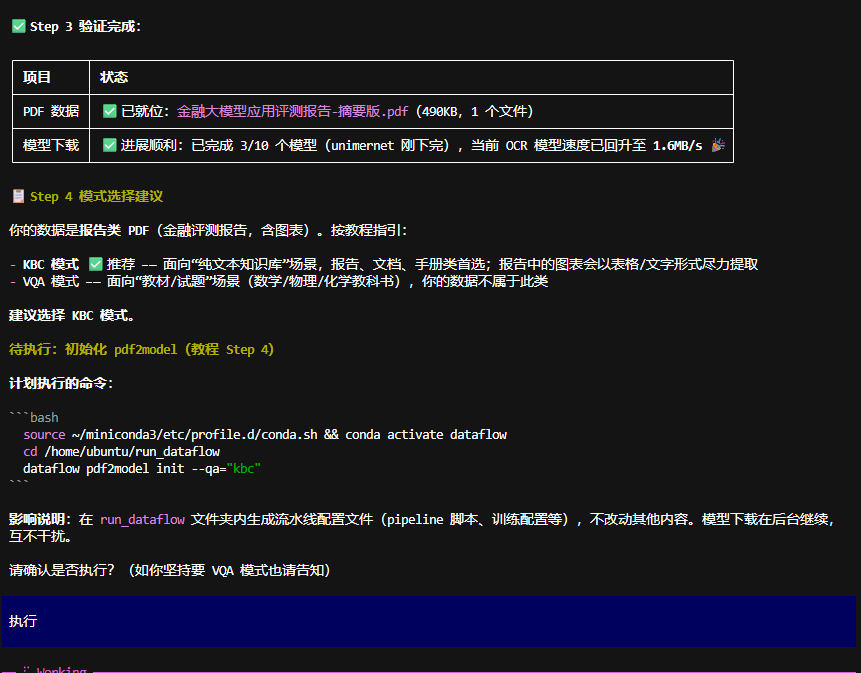
pi 先问我 PDF 是什么类型,用来决定走 KBC 还是 VQA;我答复:报告类、含图表、已上传。
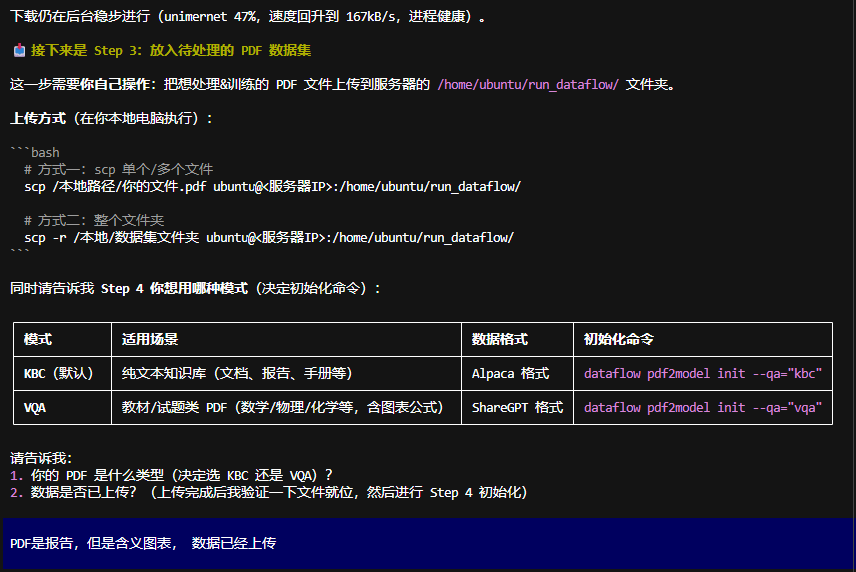
Step 5 初始化 + 配置本地化修正 + 大模型下载
5.1 初始化(选择 KBC 模式)
数据是报告类 PDF(含图表),按教程指引选 KBC(纯文本知识库 / Alpaca 格式);VQA 面向教材/试题类,这里不适用。
| |
init 和模型下载是并行推进的:模型在后台下着,pi 先把目录创建和初始化做完了,互不阻塞(见 Step 2 末尾的异步规划图)。
init 完 pi 没有直接开跑,而是先把流水线源码通读了一遍,确认 dataflow pdf2model train 的完整链路是 MinerU 解析 PDF → 清洗 → 生成 QA → LLaMA-Factory LoRA 微调,顺带排查了 GPU 显存释放问题,然后列出完整的修正清单:
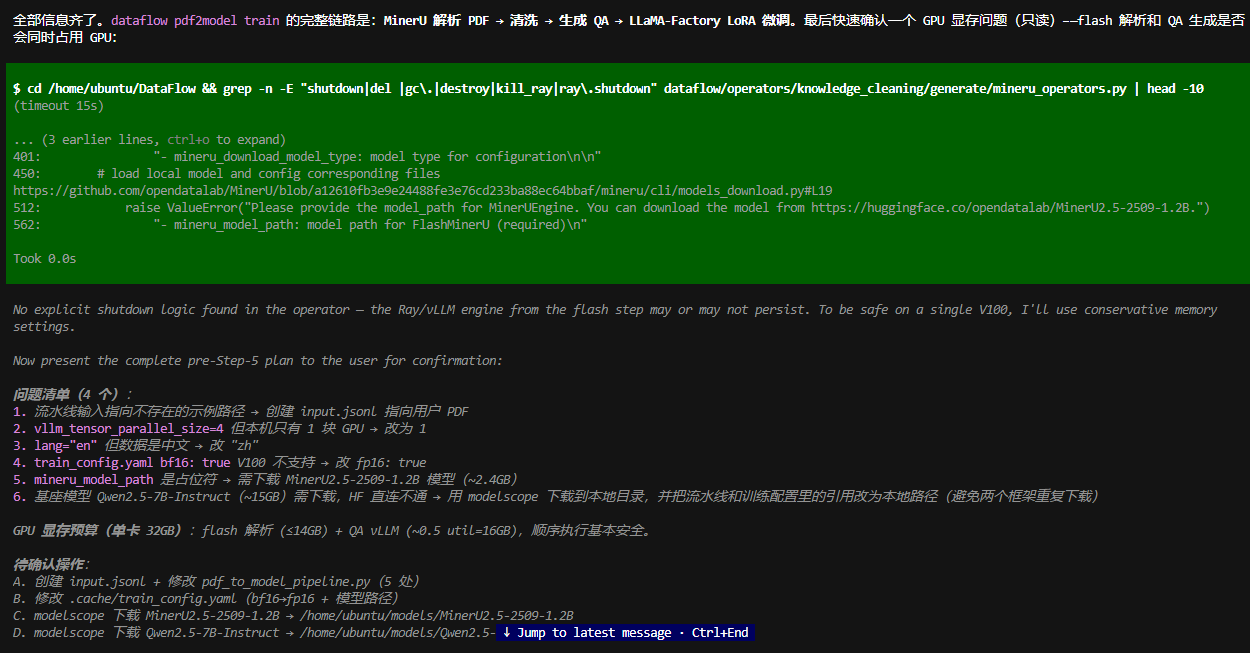
init 生成了两个关键文件:pdf_to_model_pipeline.py(主流水线)和 .cache/train_config.yaml(训练配置)。
5.2 必须做的本地化修正(单卡 V100 + 中文数据)
默认配置按 4 卡 A100 + 英文数据生成,直接训练必然失败,按下表逐项改:
新建输入清单 run_dataflow/input.jsonl(默认路径指向不存在的示例文件):
| |
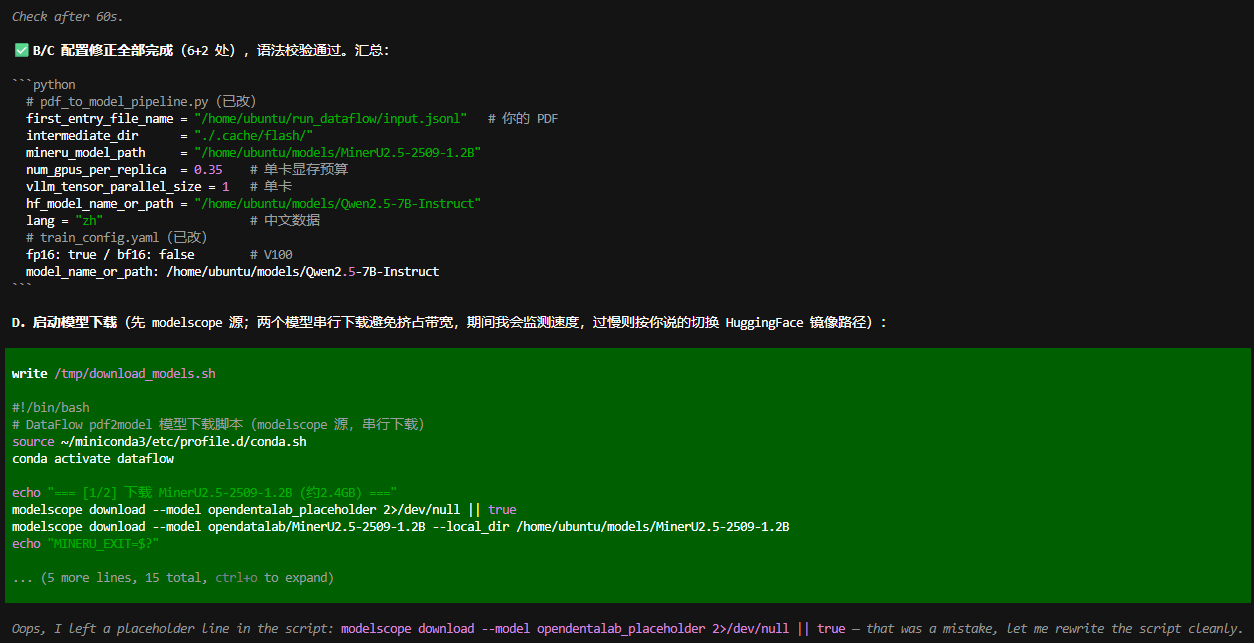
修改 pdf_to_model_pipeline.py(10 处):
| 位置 | 默认值 | 改为 | 原因 |
|---|---|---|---|
first_entry_file_name | ../../example_data/.../kbc_test.jsonl | /home/ubuntu/run_dataflow/input.jsonl | 指向自己的数据 |
intermediate_dir | ../example_data/... | ./.cache/flash/ | 中间产物落工作目录 |
mineru_model_path | "<your Model Path>/..." 占位符 | /home/ubuntu/models/MinerU2.5-2509-1.2B | Flash 解析必需,填本地路径 |
num_gpus_per_replica | 0.5 | 0.25 | Flash 引擎(1.2B)只需 ~6GB,压缩预算给后续 Qwen 引擎腾显存 |
engine_gpu_util_rate_to_ray_cap | 0.9 | 0.85 | 同上 |
tokenizer_name | Qwen/Qwen2.5-7B-Instruct | /home/ubuntu/models/Qwen2.5-7B-Instruct | 免联网拉取 |
vllm_tensor_parallel_size | 4 | 1 | 本机单卡 |
vllm_max_model_len | (未设置→32768) | 8192 | 分块仅 512 token;默认 32K 会导致 KV cache 不足报错 |
vllm_gpu_memory_utilization | 0.6 | 0.85 | Flash 释放后独占整卡,拿足 KV 空间 |
lang(两处) | "en" | "zh" | 中文报告 |
修改 .cache/train_config.yaml(V100 架构限制,不改训练直接报错):
| |
修正后的流水线关键片段:
| |
单卡显存编排是最大的坑:Flash 解析引擎的 Ray actor(约 14.5GB)解析完不会自动释放显存,
MineruEngine也没有 shutdown 接口;不处理的话,后面 Qwen 7B 引擎(约 19GB)一加载就是 CUDA OOM。要在流水线forward()里、step1 解析完成后加释放逻辑:
1 2 3 4def _release_mineru_gpu(self): # 逐个 ray.kill(actor, no_restart=True)(遍历 pipeline.pdf2img / process_img / img2md 的 actors) # → ray.shutdown() → gc.collect() → torch.cuda.empty_cache() # → 轮询等待 GPU 空闲率 >90% 再继续(Ray 释放是异步的)另外 step5 取数列名为
input_qa_key="QA_pairs"(注意大写,误写Qa_pairs会找不到列报错)。前面截图里 pi 列的正是这 4 个问题:示例路径不存在、
tensor_parallel_size=4、lang="en"、train_config.yaml的 bf16——跟这张表一一对应。
5.3 下载两个大模型(约 17.4GB)
| |
长任务后台运行模板(防会话误杀 + 断点续传 + 失败自动重试):
1 2 3 4setsid nohup bash -c 'for i in $(seq 1 10); do \ huggingface-cli download Qwen/Qwen2.5-7B-Instruct \ --local-dir /home/ubuntu/models/Qwen2.5-7B-Instruct && break; sleep 5; done' \ > /tmp/dl_qwen.log 2>&1 < /dev/null &下载完验证完整性:Qwen 目录应有 4 个 safetensors 分片(3.7G+3.6G+3.6G+3.4G)加 tokenizer 文件。
Step 6 一键微调模型
| |
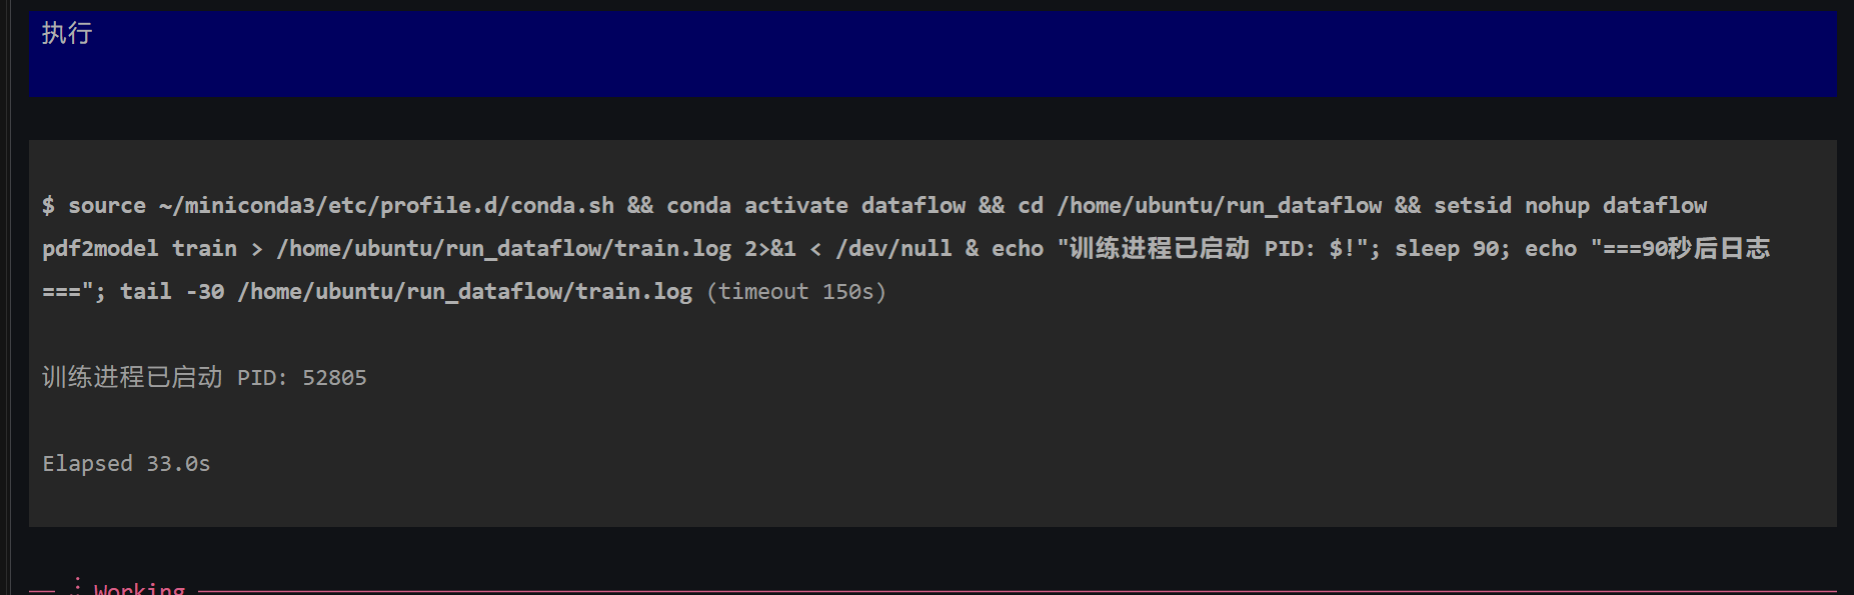
流水线内部依次执行(日志中依次出现):
| |
成功的标志和产物:
| |
如果数据已处理完、只改了训练配置,不用重跑全流程,直接执行第 4 步的等价命令:
llamafactory-cli train .cache/train_config.yaml
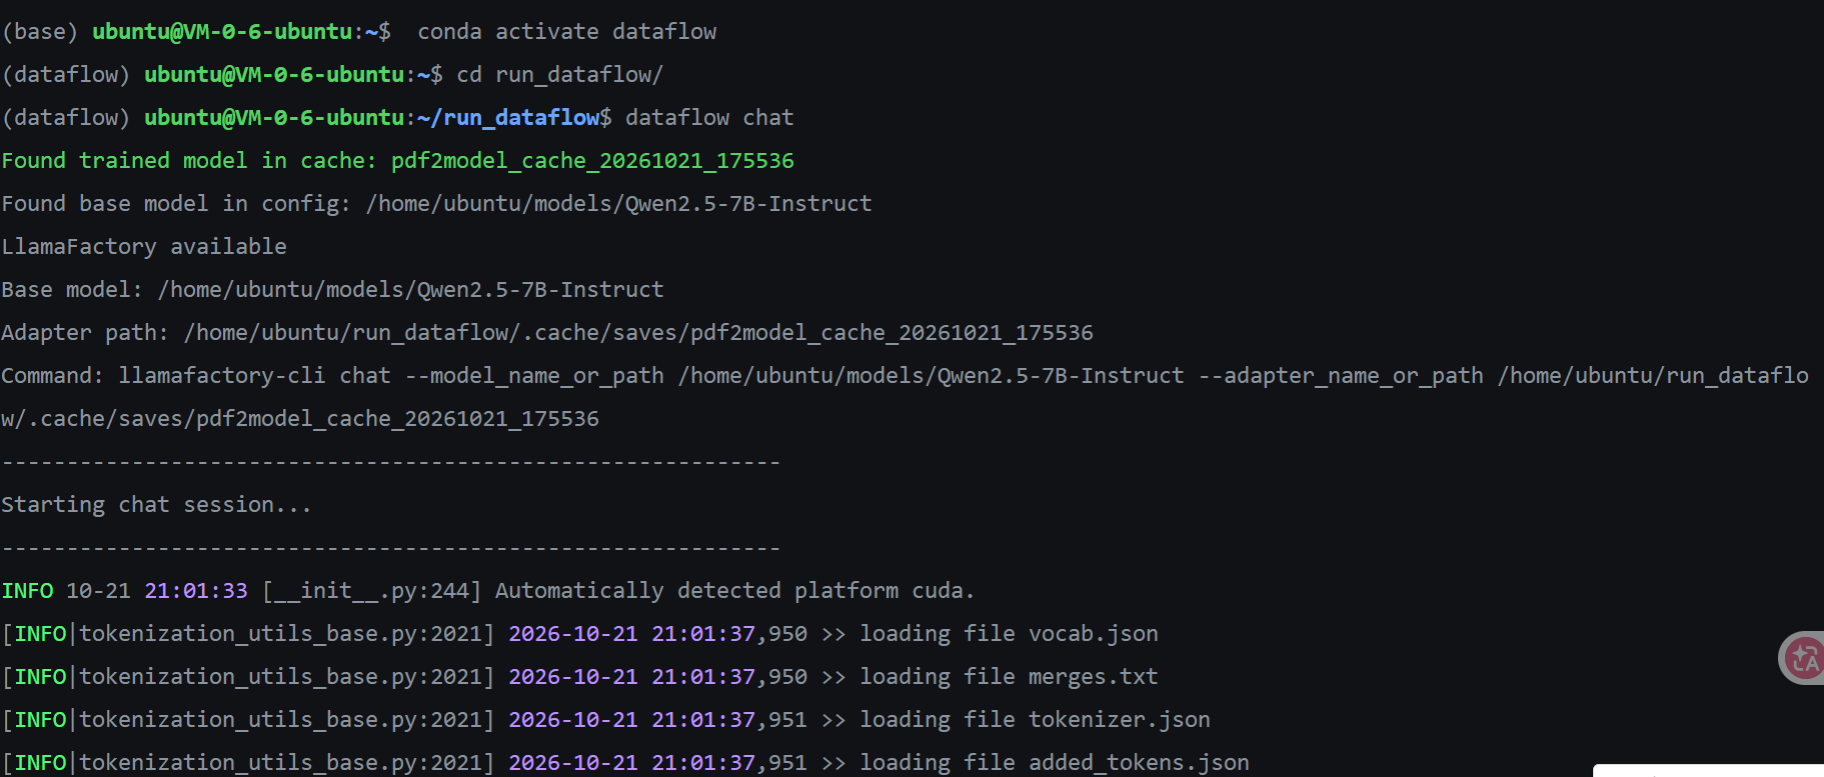
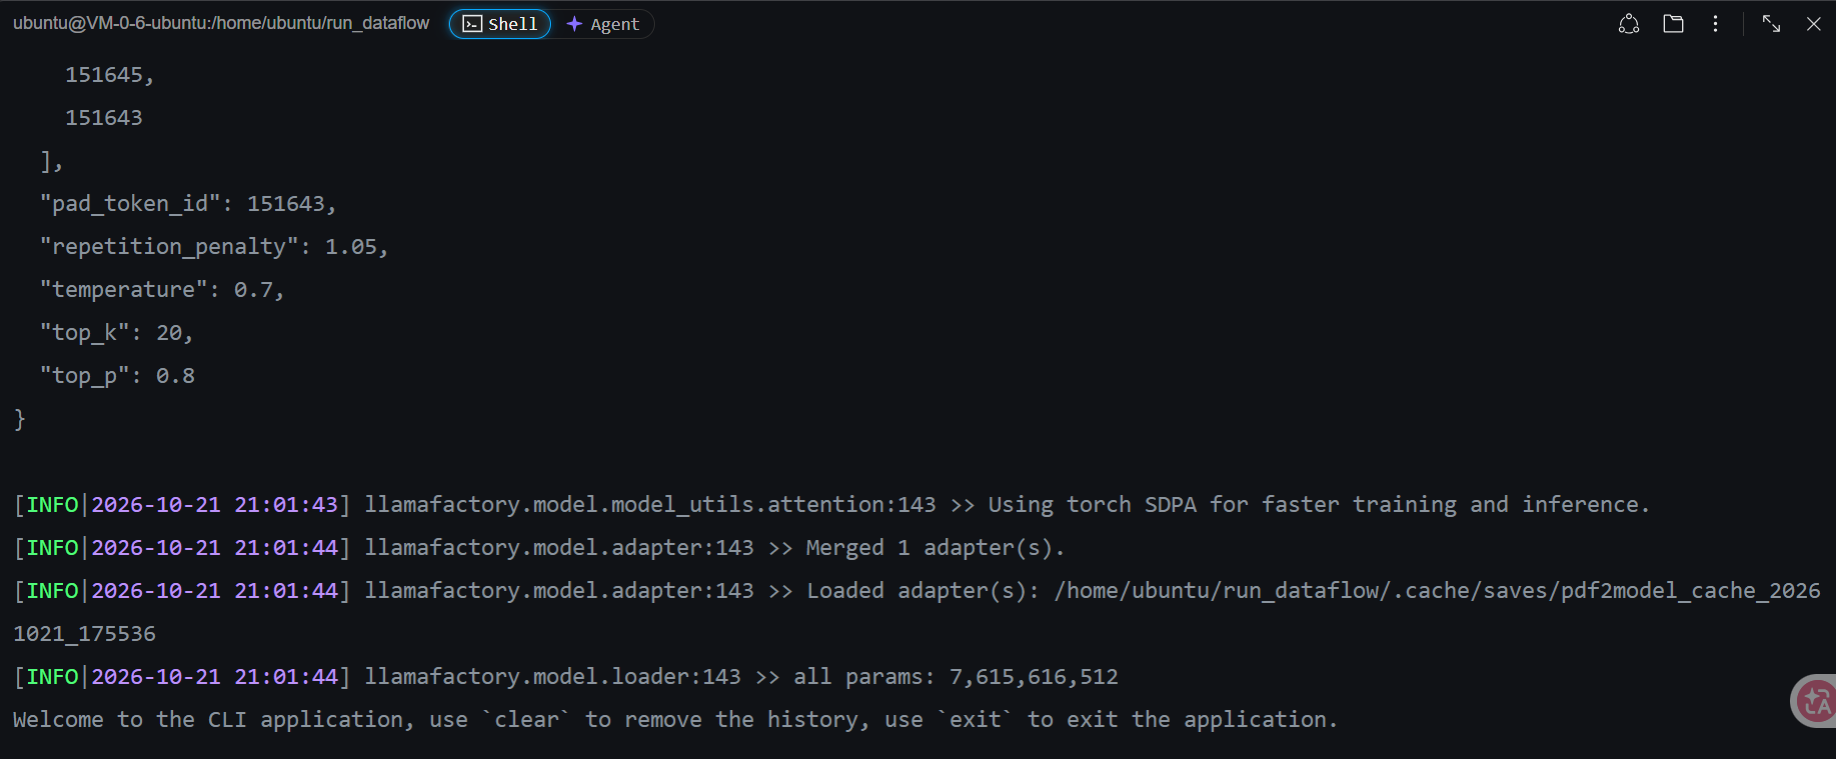
Step 7 与微调模型交互验证
| |
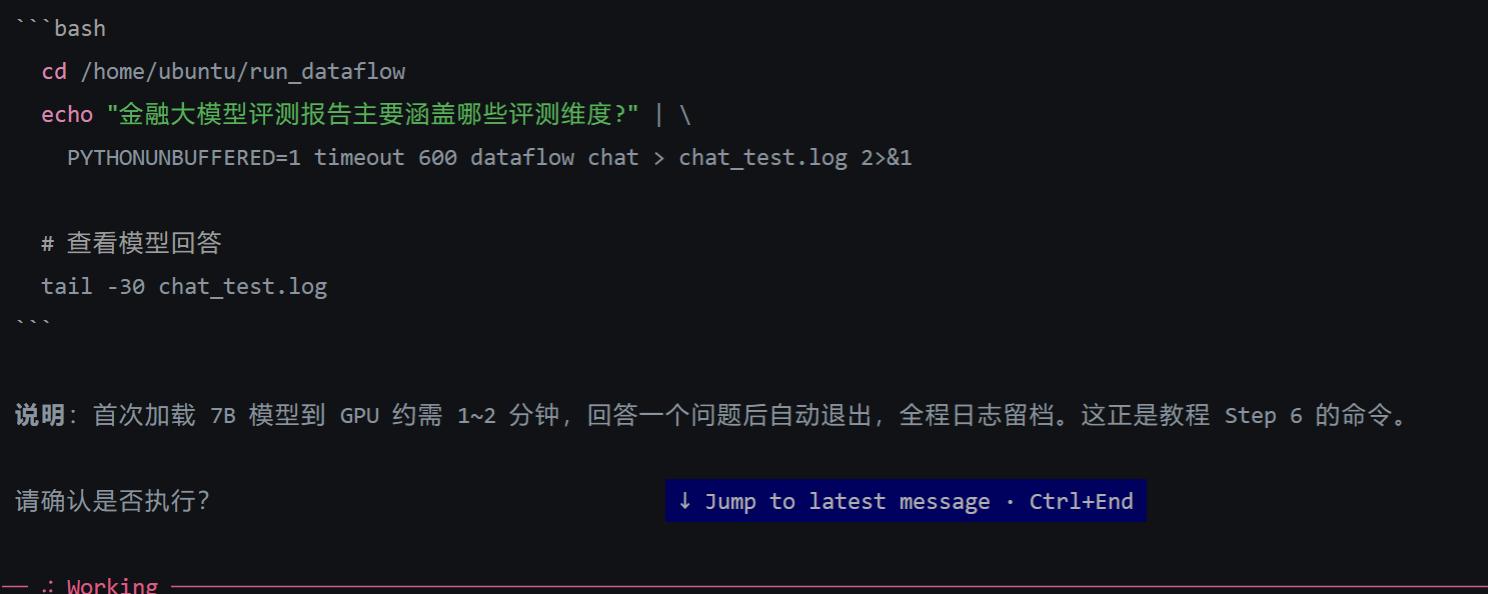
问一个基于报告内容的问题验证效果:
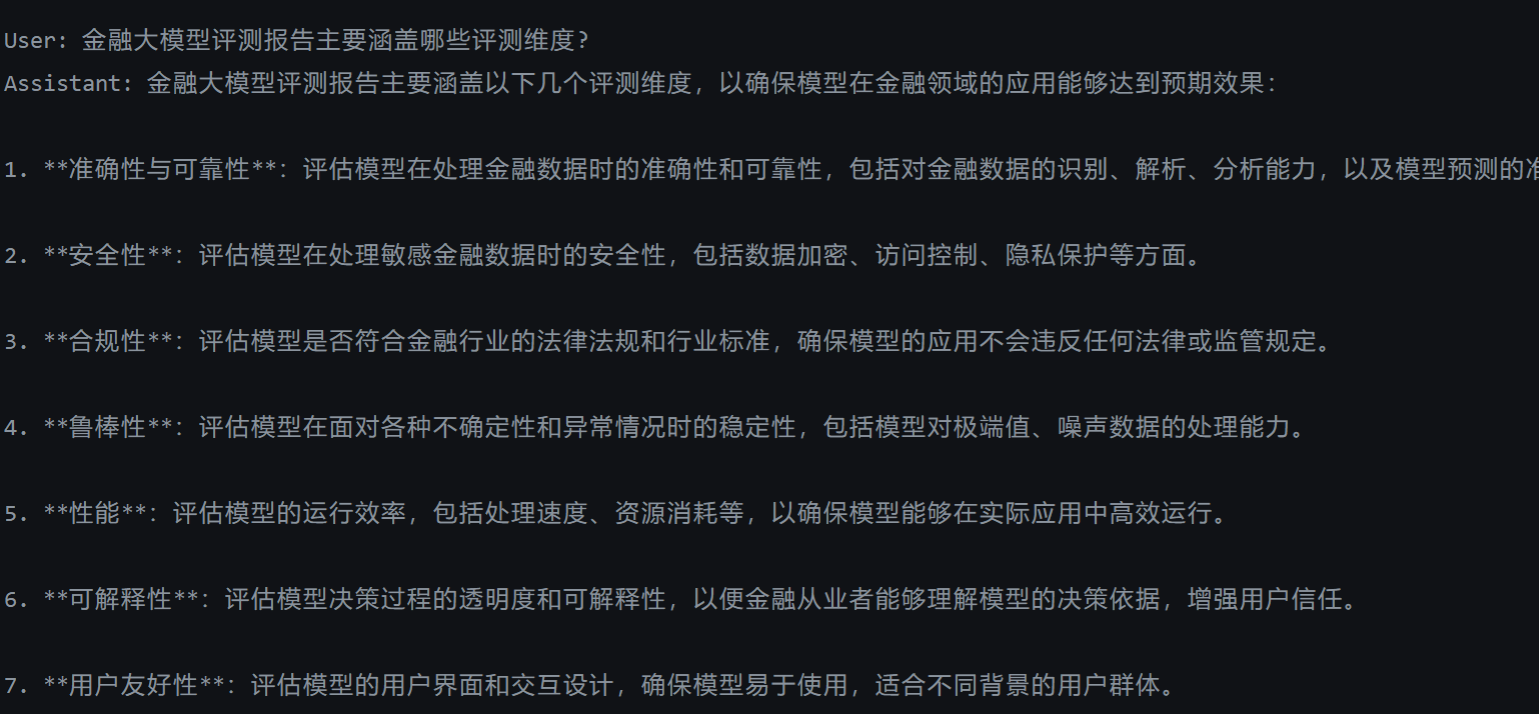
User:金融大模型评测报告主要涵盖哪些评测维度?
Assistant:金融大模型评测报告主要涵盖以下评测维度:1. 技术性能(准确性/稳定性/响应速度)… 2. 安全性 … 3. 可解释性 … 4. 遵守法规 … 5. 用户体验 …
回答紧扣报告主题、结构清晰,链路是通的。
Step 8 量化效果测评(dataflow eval,对应教程 1.1.2)
教程 1.1.2 的对比部分全是截图(同题问答对比加 base/fine_tuned 分数汇总),评分脚本没有随教程提供。好在 DataFlow 仓库自带同一套框架 dataflow eval(LLM-as-judge 裁判打分),直接拿它做"训练前 vs 训练后"的分数对比。
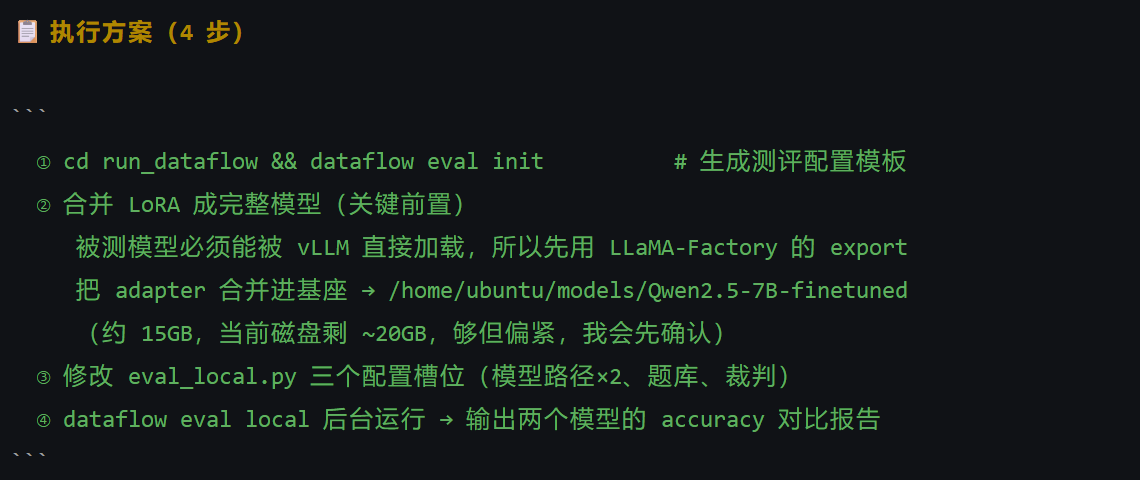
pi 给出的四步方案:eval init → 合并 LoRA → 改三个配置槽位 → 后台运行出对比报告:
8.1 前置准备
显存互斥:测评需要约 27GB 显存,先在 chat 终端输入
exit退出,nvidia-smi确认 0 MiB 再继续。磁盘准备:合并后的完整模型约 15GB,磁盘不够先清理安全缓存:
rm -rf ~/.cache/pip ~/.cache/modelscope /tmp/miniconda.sh(释放约 7.6GB;modelscope 缓存已确认是重复残留,mineru 现用 HF 路径)
8.2 初始化测评配置
| |
8.3 合并 LoRA 为完整模型(关键前置)
被测模型必须能被 vLLM 直接加载,先用 LLaMA-Factory 把适配器合并进基座:
| |
| |
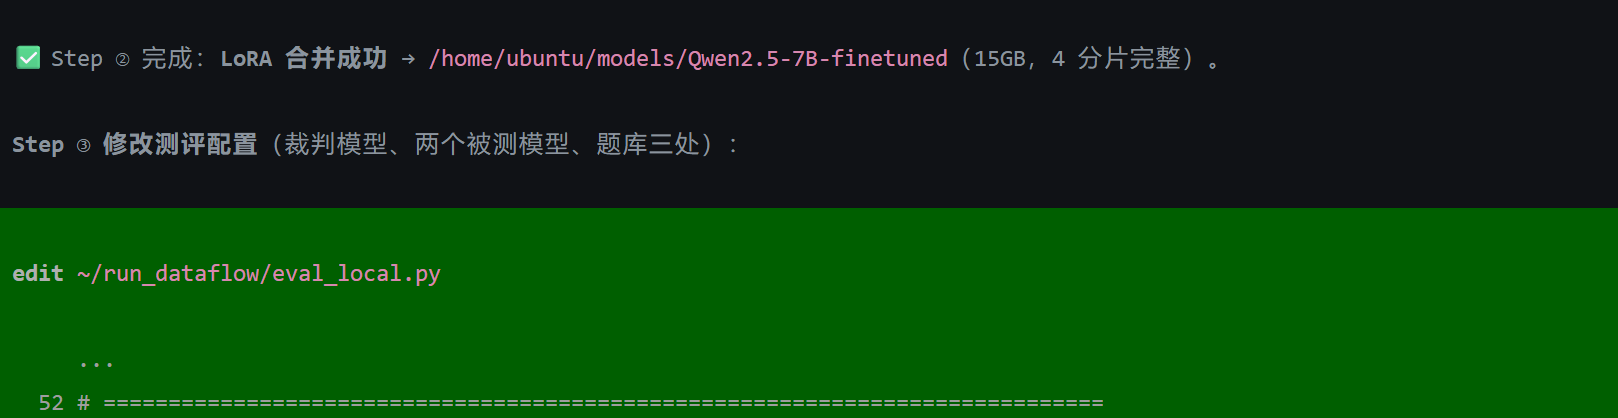
8.4 修改 eval_local.py(三个槽位 + 一个官方模板 bug)
裁判模型 JUDGE_MODEL_CONFIG:
| |
被测模型 TARGET_MODELS(两个条目,参数一致才公平):
| |
题库 BENCH_CONFIG:
| |
官方模板有个 bug:模板自带的
FairAnswerJudgePrompt是普通类,会被判卷算子的@prompt_restrict校验拒绝,报Invalid prompt_template type。修复方法是改成继承DIYPromptABC(build_prompt签名不用动):
1 2 3 4from dataflow.core.prompt import DIYPromptABC class FairAnswerJudgePrompt(DIYPromptABC): def __init__(self): super().__init__() def build_prompt(self, question, answer, reference_answer): ...(原内容不变)
8.5 运行测评
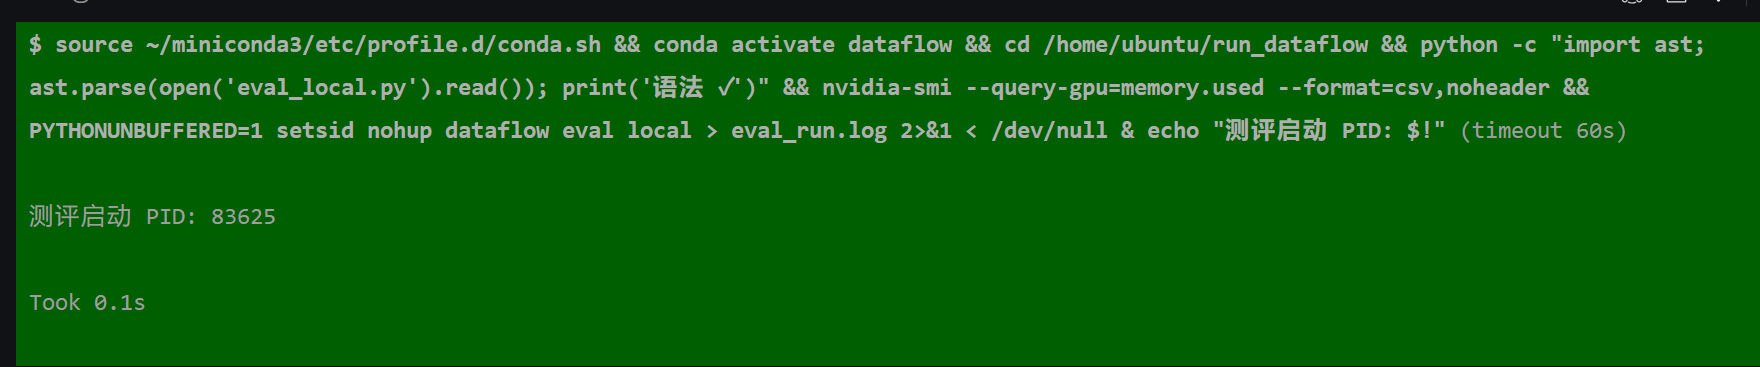
长任务建议写成独立启动脚本再
setsid nohup,避免 shell&&链与&的优先级坑(直接内联曾导致启动失败且无日志)。
| |
流程自动串行:基座答 40 题 → 微调模型答 40 题 → 裁判判卷 80 条 → 出报告,全程约 5 分钟。
8.6 测评结果
| |
产物:
| |
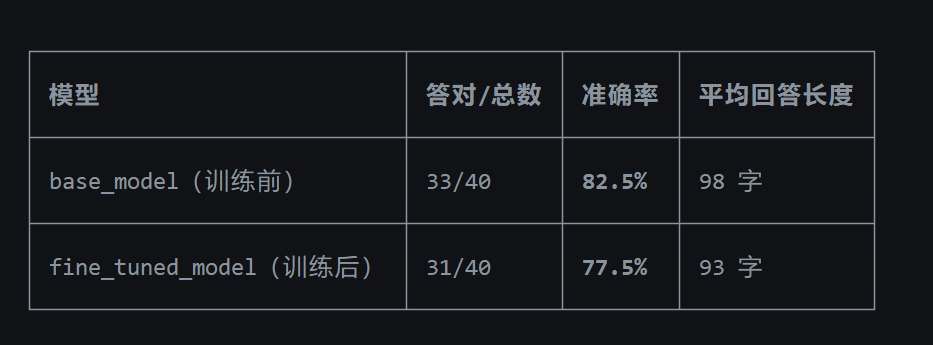
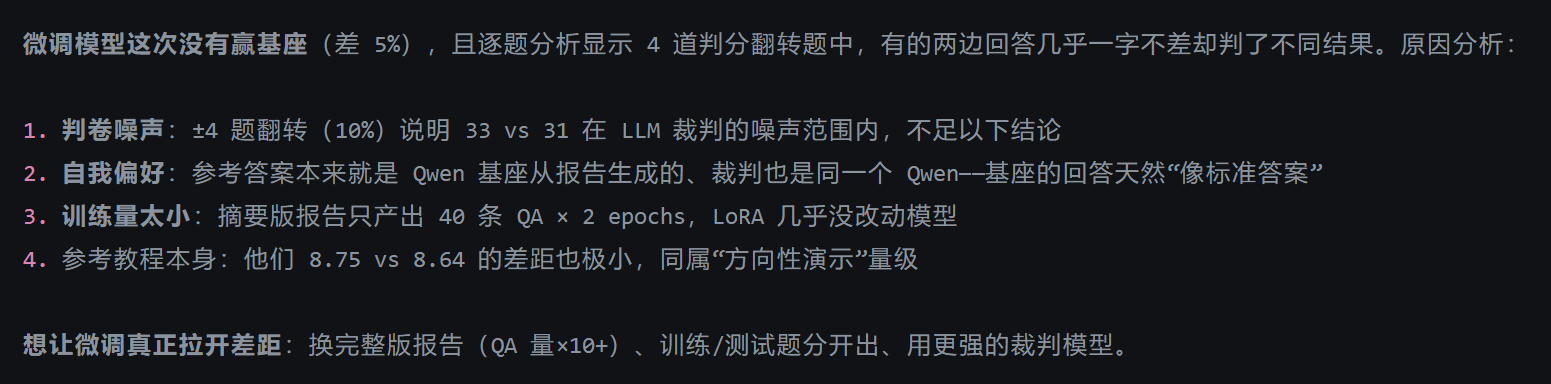
结果说实话不理想:微调后反而比基座低 5 个点。逐题翻看 4 道判分翻转题,有的两边回答几乎一样却判了不同分。分析下来三个原因:一是 LLM 裁判本身有噪声(±10% 量级);二是参考答案由 Qwen 基座生成,裁判也是同一个 Qwen,存在自我风格偏好;三是摘要版报告只产出 40 条 QA,训练量太小。这不是流程问题,是数据量问题——换完整版报告(QA 量翻 10 倍以上)、训练/测试题分离、换更强的裁判模型,差距才会拉开。教程里演示的 8.75 vs 8.64 差距也极小,同属方向性验证的量级。
Step 9 1.2 节 GPU 版实操(dataflow init + 独立 KBCleaning 流水线)
1.2 教程的原样是:安装 → dataflow init → 改 first_entry_file_name → 跑通一条流水线 → 查看缓存结果,以 CPU 版为例。我直接上 GPU 版:能力更强(PDF+URL 混合源、LLM 清洗/QA 生成),环境全部复用 1.1,什么都不用重装。
9.1 复用说明(不重装任何东西)
| 1.2 教程命令 | 我们的处理 |
|---|---|
pip install open-dataflow | 跳过——1.1 已装源码版(-e .[pdf2model]),重复安装会用 PyPI 包覆盖 |
| conda 环境 / 模型 / 系统库 | 全局共享层,直接复用 |
| 新建文件夹 | 仅需 mkdir + dataflow init(秒级,纯模板文件复制) |
9.2 新建工作区并初始化
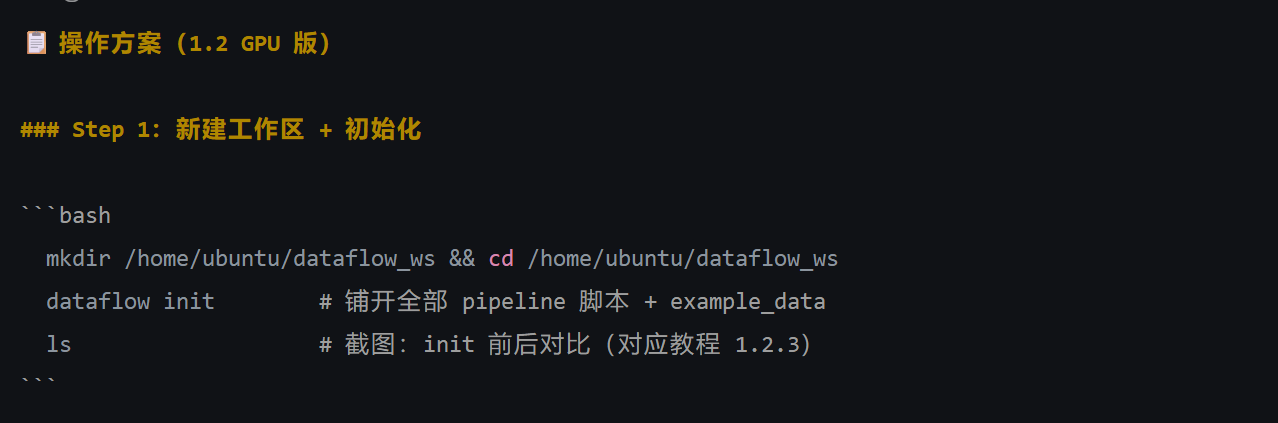
| |
init 后当前目录出现:cpu_pipelines/、gpu_pipelines/、api_pipelines/、example_data/、playground/、core_text/、simple_text_pipelines/——就是教程"init 前后对比"截图里的内容。
9.3 修改输入清单与 GPU 流水线
修输入路径:example_data/KBCleaningPipeline/kbc_test.jsonl 里的 PDF 相对路径失效,改绝对路径;3 个 URL 保持不变:
| |
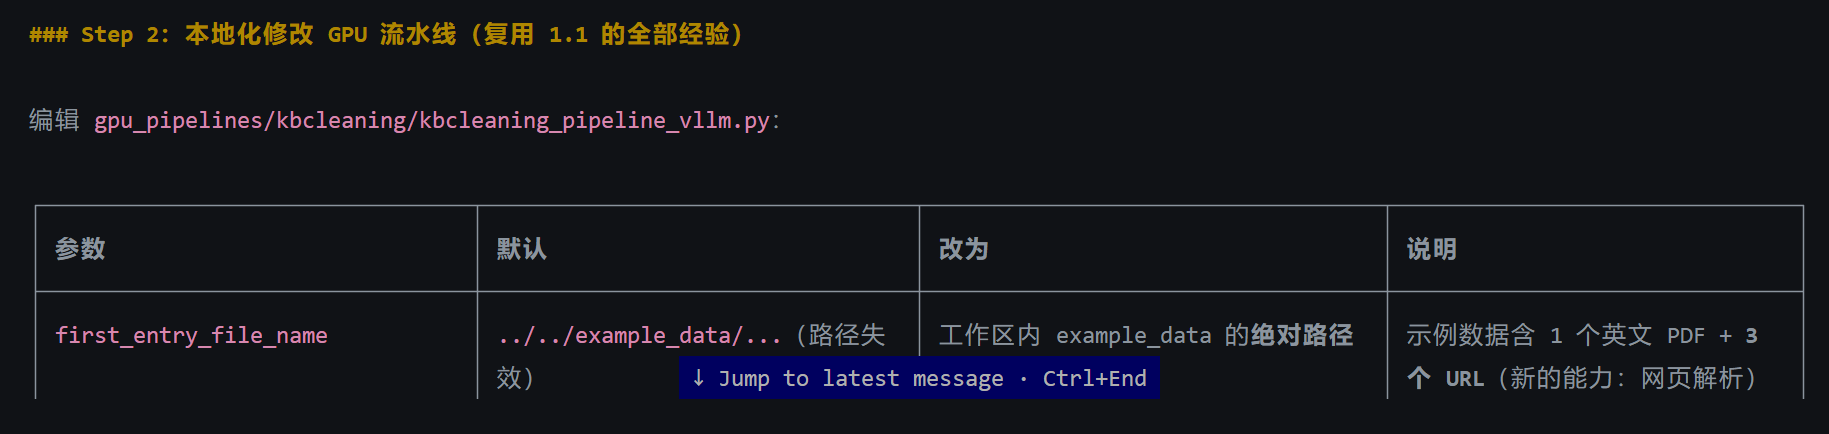
改 gpu_pipelines/kbcleaning/kbcleaning_pipeline_vllm.py(与 1.1 同配方,差异只有两点):
| 参数 | 改为 | 与 1.1 的差异 |
|---|---|---|
first_entry_file_name | 工作区内 kbc_test.jsonl 绝对路径 | 数据源含 URL(新能力) |
mineru_model_path / tokenizer_name / hf_model_name_or_path | 本地模型绝对路径 | 同 1.1 |
num_gpus_per_replica/util | 0.25/0.85 | 同 1.1(单卡显存编排) |
vllm_tensor_parallel_size / max_model_len / gpu_memory_utilization | 1 / 8192 / 0.85 | 同 1.1 |
lang | 保持 “en” | 注意:示例数据是英文,与 1.1 的 zh 相反 |
| 附加逻辑 | _release_mineru_gpu() + input_qa_key="QA_pairs" | 同 1.1(两个已知坑) |
9.4 独立运行流水线
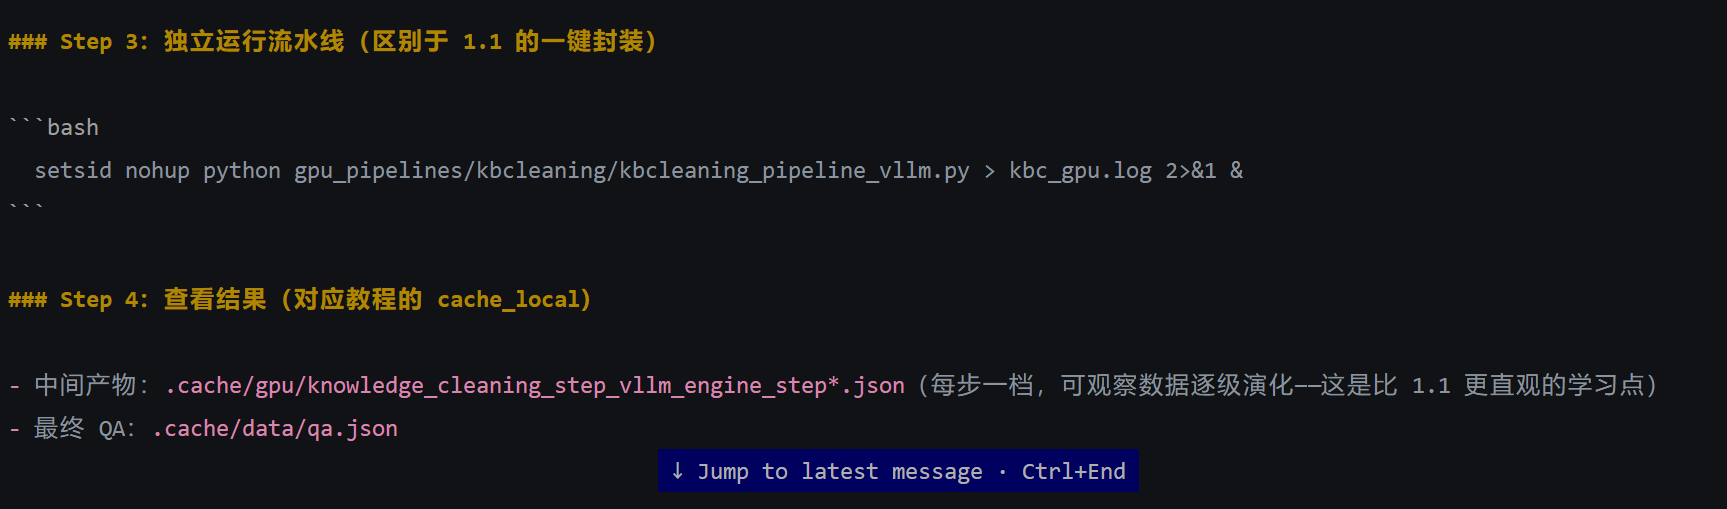
区别于 1.1 的 dataflow pdf2model train 一键封装,这里直接 python 执行流水线脚本,结构更直观:
| |
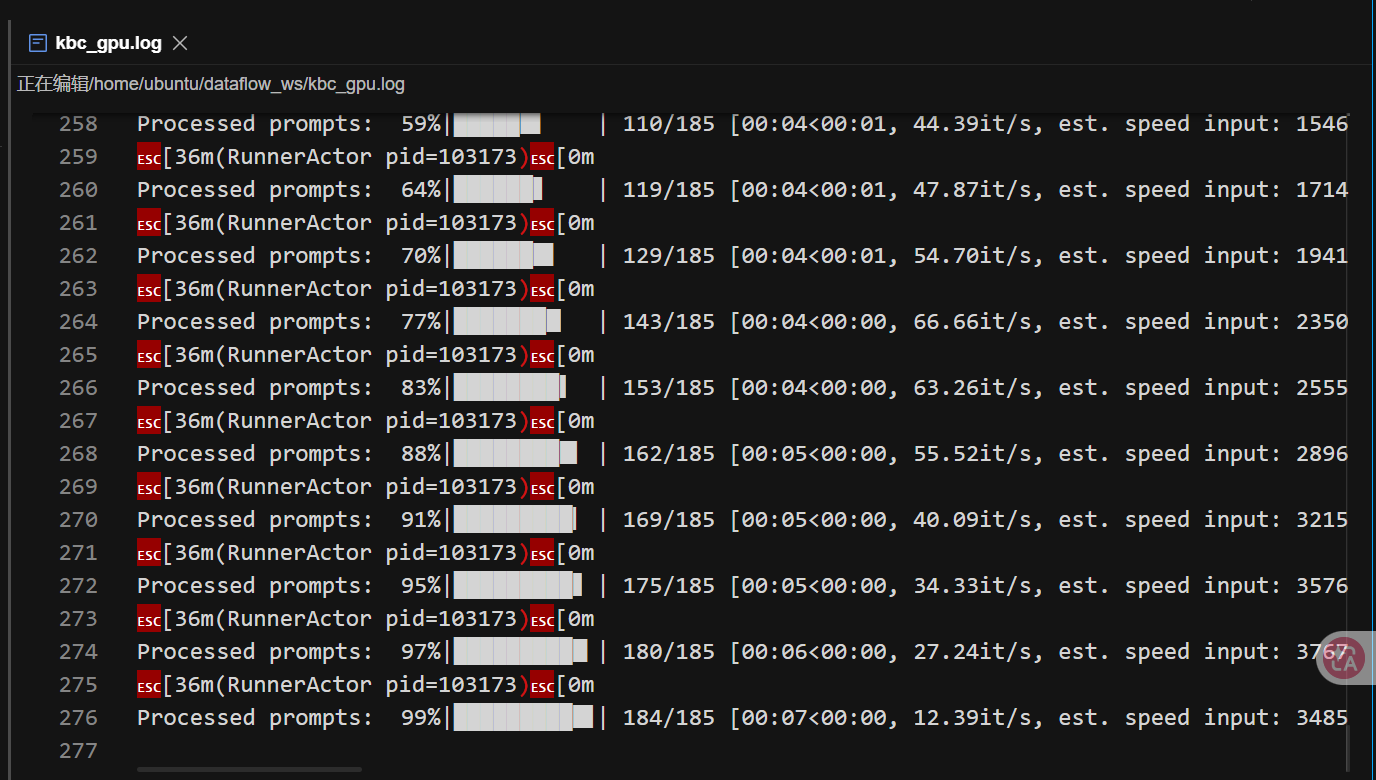
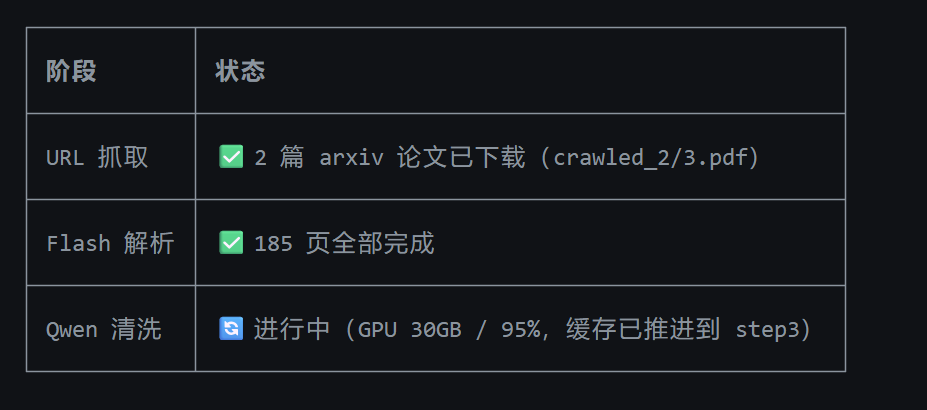
运行过程要点(日志中依次出现):
- URL 自动抓取:2 篇 arxiv 论文下载为
raw/crawled/crawled_*.pdf,网页走 HTML 解析通道 - Flash 解析 185 页(GPU ~11.5GB/100%)→
_release_mineru_gpu()释放 → Qwen 清洗/QA(GPU ~30GB/95%) - 全程约 15~20 分钟
已知问题:vLLM 退出阶段可能挂起不自动结束(结果已全部落盘,不影响),需要
pkill -9 -f kbcleaning手动清理。
9.5 结果:数据逐级演化(1.2 最值得看的部分)
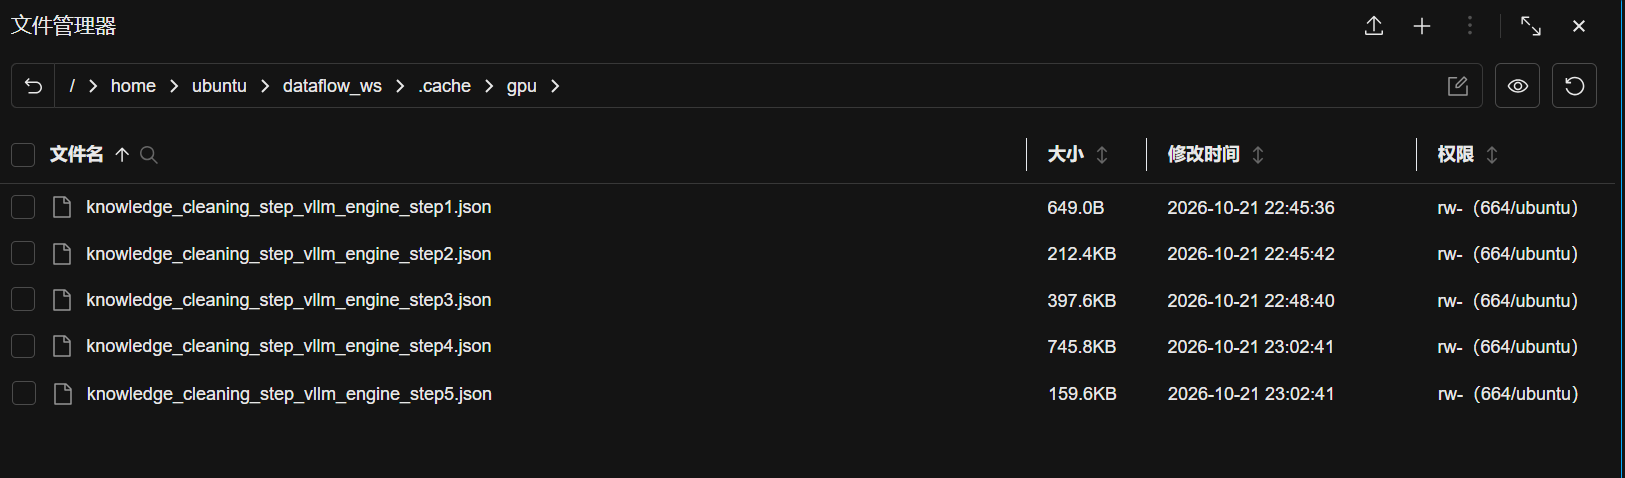
.cache/gpu/ 下每个 step 一档(教程说的 cache_local 等价物),可以直接观察数据演化:
| 步骤 | 产物 | 数据量 | 说明 |
|---|---|---|---|
| step1 | 解析结果 | 4 条 | 1 本地 PDF + 2 arxiv URL + 1 网页 → Markdown |
| step2 | 文本分块 | 115 条 | 512-token 块 |
| step3 | 知识清洗 | 115 条 | Qwen 逐块英文清洗 |
| step4 | QA 生成 | 91 条有效块 | 每块多跳生成 5 问 |
| step5 | 格式化 | 432 组 QA | Alpaca 格式,存 .cache/data/qa.json |
质量抽样(来自 arxiv 论文):
Q: What is the role of synchronous collection in managing data flow during reinforcement learning? A: Synchronous collection ensures that there’s no excessive data accumulation and manages data shortages efficiently.
最终状态确认
| 验证项 | 结果 |
|---|---|
dataflow -v | 1.0.11 |
| torch 2.7.0 + V100 | CUDA 可用 |
| PDF → Markdown | .cache/flash/.../vlm/*.md |
| QA 自动生成 | 40 组中文问答对 |
| LoRA 微调 | train_loss 3.25 / eval_loss 3.60 |
| 对话验证 | 正确回答报告相关问题 |
| 量化测评 | base 0.825 vs fine_tuned 0.775(40 题裁判判卷,含逐题明细) |
| 1.2 GPU 流水线 | PDF+URL 混合源 → 432 组英文 QA(step1~5 全链路) |
| |
这次只喂了 1 份摘要版报告(40 组 QA),目的是打通流程;换完整版报告、多喂几份 PDF,模型的领域贴合度会明显上来。
环境:腾讯云 Ubuntu 22.04 / 1×V100-32GB / Miniconda 26.9.3 / open-dataflow 1.0.11 | 2026-10-21