⚡ 一句话总结:不改造模型本身,只让多个 LLM 实例「开会辩论」几轮,就能显著减少幻觉、提升数学与策略推理能力——一个即插即用的黑盒增强框架。
📇 论文信息卡
| 项目 | 内容 |
|---|---|
| 📄 论文标题 | Improving Factuality and Reasoning in Language Models through Multiagent Debate |
| 🔗 论文地址 | arXiv:2305.14325 · alphaXiv 页面 · PDF |
| 👥 作者 | Yilun Du, Shuang Li, Antonio Torralba, Joshua B. Tenenbaum, Igor Mordatch |
| 🏛️ 机构 | MIT CSAIL & Google Brain |
| 📅 发表 | arXiv 2023.05(ICLR 2024) |
| 💡 一句话介绍 | 提出 Multiagent Debate 框架:多个 LLM 实例各自作答、多轮互相辩论,最终收敛到共识答案,以「社会心智(society of minds)」方式提升事实性与推理能力 |
🎯 需求:为什么要做这个研究
LLM 虽然能力惊人,但有两个老大难问题:
- 幻觉(Hallucination):一本正经地编造事实,且置信度很高;
- 推理不稳:面对数学、策略类任务,单模型容易产出错误或矛盾的推理链。
已有方案(验证、self-consistency、scratchpad、CoT 等)都在改进单个模型实例。这篇论文换了个思路:让多个模型实例之间互相交互——通过结构化辩论与共识机制,取长补短。
关键卖点:
- ✅ 只需黑盒访问模型(不改权重、不看内部),任何现成 LLM 都能用;
- ✅ 所有任务用同一套流程与 prompt,通用性强;
- ✅ 可与 CoT 等已有技术叠加使用,收益再增。
💡 方法:多智能体辩论怎么做
流程像一个「圆桌辩论赛」:
- 初始化:启动 N 个 LLM 实例作为辩手 agent;
- 独立作答:每个 agent 先独立给出候选答案;
- 多轮辩论:每轮每个 agent 看到其他所有 agent 的答案,然后更新自己的答案(可反驳他人、可坚守己见);
- 迭代收敛:重复若干轮,答案逐步互相纠错;
- 达成共识:最终收敛到一个共识答案,作为输出。
核心伪代码:
| |
Prompt 设计上有个反直觉细节:「长辩论 prompt」会让模型在后期更「固执」地坚持自己的正确解,从而提升最终共识的质量。
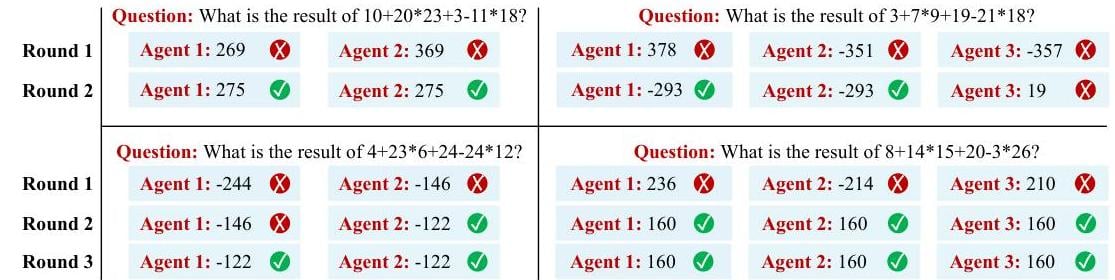 图 2:辩论过程示例——即使部分 agent 初始答案是错的,经过几轮辩论也能收敛到正确答案。
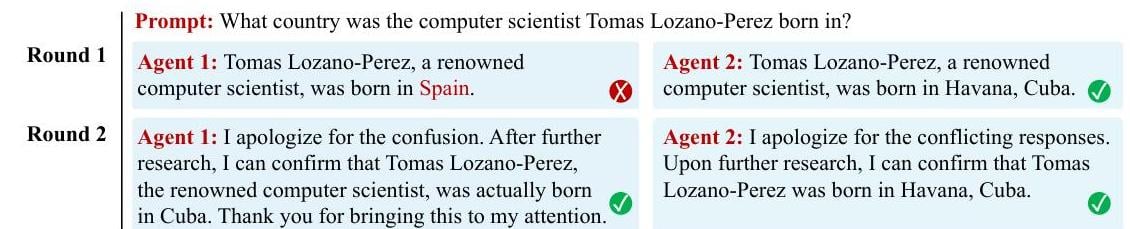 图 4:事实纠错实例——Agent 1 起初错说 Lozano-Perez 出生于西班牙,与 Agent 2 辩论后纠正为古巴。
📊 结果:核心实验数据
评测覆盖算术、GSM8K 小学数学、国际象棋走子、MMLU、人物传记生成(作者新建的 524 位计算机科学家事实性基准)五大类任务。
| 任务 | 单模型基线 | 多智能体辩论 | 提升 |
|---|---|---|---|
| 算术 | 67% | 82% | +15 |
| GSM8K 数学 | 77% | 85% | +8 |
| 象棋走子最优性 | 74% | 100% | +26 |
| MMLU | 64% | 71% | +7 |
| 传记事实准确率 | 66% | 74% | +8 |
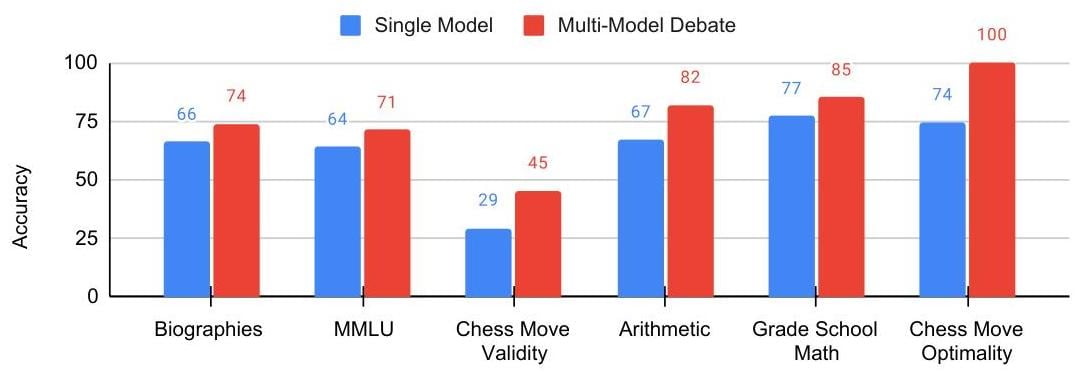 图 1:各任务上一致优于单模型基线。
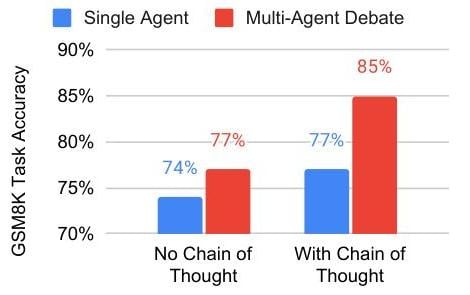 图 3:与 CoT 叠加后收益继续放大(GSM8K 77% → 85%)。
消融实验:
- Agent 数量:1→5 个持续涨点,5 个后边际收益递减;
- 辩论轮数:3 轮左右基本饱和,继续加轮数收益有限。
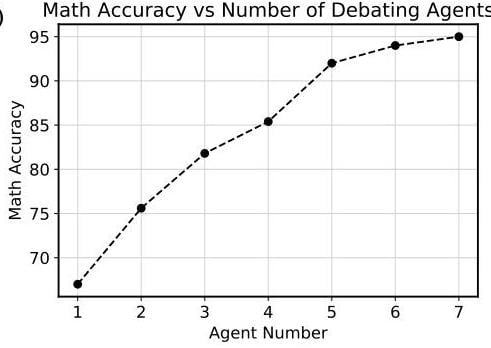 图 5:数学准确率随辩手数量提升,约 5 个后趋于饱和。
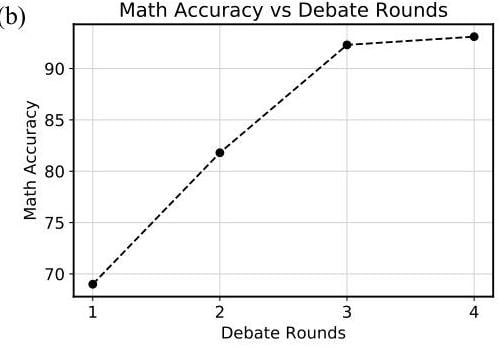 图 6:3 轮辩论后收益递减。
✅ 结论
- 辩论即增强:多实例结构化辩论是一种与「改进单模型」正交的互补路线,能同时改善事实性与推理能力;
- 黑盒、通用、零改造:同一套流程和 prompt 通吃所有测试任务,可直接套在任何现成 LLM 上;
- 性价比可调:5 个 agent + 3 轮辩论基本就能拿到大部分收益;
- 可组合:与 CoT 等技术叠加可获得额外提升。
🔮 后续精读计划:值得深入的方向——共识判定机制、辩论 prompt 的具体构造、与 self-consistency 的严格对比、多 agent 带来的推理成本开销分析。待精读后补充。
本文为论文快读笔记,图片来自论文原文(arXiv:2305.14325),仅作学习交流使用。