这是一篇用趣味框架做的类比解读,帮人快速理解世界模型是什么,不是严格的学术分类。
世界模型(World Model)最近被反复提起,很多人默认它是下一代大模型的专属黑科技。
但它从来不是 AI 的专利。下面这张借用 D&D 阵营九宫格形式画的图,把一堆你熟悉的东西排在一起——你会发现,「对世界建模」这件事,人类已经干了几千年。
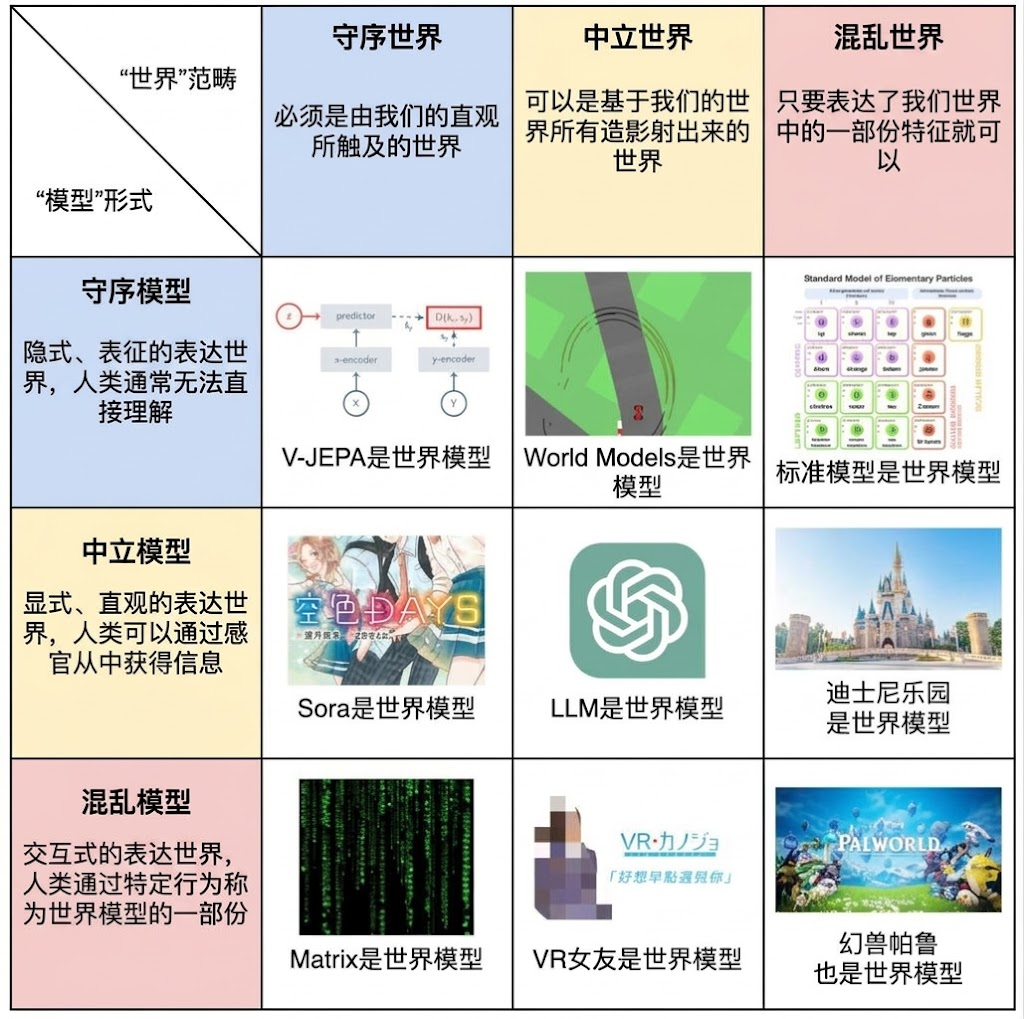
图里两条轴:
- 横轴看「这个世界有多贴近真实」:真实世界 → 投影世界(从现实复刻)→ 虚构世界(只抓部分特征)。
- 纵轴看「我们怎么接触它」:机器可读的底层表征 → 人眼可见的画面 → 能走进去互动的空间。
三行三列,九个格子。
第一行:给机器读的世界模型
共同点:用数字、公式、向量描述世界,人看不懂,是给机器算的。这也是「世界模型」最学术的定义——智能体对外部世界的内部隐式表征,用来预测行动后果、推演未来状态。
真实世界 + 机器可读:V-JEPA
图灵奖得主杨立昆(Yann LeCun)主推的路线,狭义世界模型的代表。它直接学真实世界,把画面、物体、物理规律编码成机器能读的抽象向量;不生成画面,只在内部预测「接下来会发生什么」,供 AI 规划推理。
杨立昆的观点:人脑推演世界不会精细到每个像素,只抓关键信息。JEPA 走的就是这条「压缩式抽象」的路——只留对推理和行动有用的特征,过滤掉无关细节。2025 年的 V-JEPA 2 更进一步,已经能基于视频预测直接做规划和机器人控制。
投影世界 + 机器可读:World Models
2018 年 David Ha 与 Jürgen Schmidhuber 的经典论文《World Models》,奠定了现代 AI 世界模型的基础框架。它不直接建模现实,而是搭一个从现实映射来的虚拟投影世界,全部用压缩的状态向量存。AI 在这个「梦境」里反复试错、推演决策,再把策略搬回现实。人看不到这个世界。
这篇论文的核心洞见:智能体不必基于原始观察行动,可以先把现实压成更小的内部表征,再拿它预测未来、支撑决策。
虚构世界 + 机器可读:粒子物理标准模型
听着和 AI 没关系,但它就是一套用数学公式写成的世界模型。它不描述整个宇宙,只抓微观粒子这一部分特征,用方程定义运行规则。普通人读不懂这些公式,但它们精确描述了世界的底层逻辑——跟 AI 世界模型用向量描述规律是同一件事:用一套人无法直接感知的符号系统,精准建模世界的某一部分。
第二行:给人看的世界模型
这一行用画面、文字、实景呈现,不用解码,看一眼就懂。也是大众最常接触的形态——把世界「渲染」成人眼能接收的画面。
真实世界 + 直观可见:Sora
Sora 被叫世界模型,不是因为它会生成视频,而是它学到了真实世界的物理规律。底层怎么算不用管,播放出来就是模拟出的真实场景。
OpenAI 干脆把 Sora 的技术报告取名为《Video generation models as world simulators》——视频生成模型可以被看作世界的模拟器。按功能说,它干的是「渲染」的活:以像素输出人眼可见的画面,指标是视觉保真度,生成的是「观察者将要看到的景象」。
投影世界 + 直观可见:大语言模型(LLM)
大模型把现实世界的知识、常识、逻辑学进参数,再用文字输出——文字是现实世界的一种投影,读就能获取信息。
有一点要说清楚:说「LLM 具备世界模型能力」,指的是它内部隐式的知识表征——参数里编码了空间、因果、物理规则,这部分人看不懂,文字只是显式结果。多项研究已证实,大模型内部确实会隐式编码空间和物理表征。
虚构世界 + 直观可见:迪士尼乐园
不用 1:1 还原现实,只提取童话的核心特征,在现实里搭出能逛的场景。走进去看和体验,就能直观感受到这个虚构世界,规则和剧情不用你操心。说穿了,它是一个用建筑、表演、音效搭出来的「实体渲染器」,把虚构世界观变成人能直接体验的东西。
第三行:让人参与的世界模型
这一行不再是旁观:你走进去,行为会改变世界状态,人成了世界的一部分。对应仿真、交互类世界模型,也是游戏、数字孪生的底层逻辑。
真实世界 + 互动参与:《黑客帝国》Matrix
肉身留在真实世界,意识接入虚拟母体。你在里面行动、选择,行为改变虚拟世界的走向,自己成了模型的一部分。这是交互式世界模型的极致想象:感知完全接入,行动直接作用于模型内部,人和模型形成一个闭环。
投影世界 + 互动参与:VR 女友
从真实的人物形象、社交关系投影出一个虚拟世界。戴上 VR,就能和角色对话互动,每个动作都有反馈,从看客变成参与者。这类应用基于现实特征构建,同时允许你的行为影响世界状态——面向人的交互式世界模型。
虚构世界 + 互动参与:《幻兽帕鲁》
完全虚构的游戏世界,只借鉴现实里生存、建造、生物的部分特征。玩家进去后探索、建造、抓帕鲁,每一步都在改变这个世界,人和世界持续双向互动。电子游戏是虚构交互式世界模型里最成熟的一种:有自己的规则,接收玩家输入,实时推演状态变化。
世界模型的本质:人类「造世界」的所有方式
这张图的价值,是打破「世界模型 = AI 技术」的窄视野。
人类文明干了几千年的事,其实就是用不同媒介造世界。物理定律是拿公式写世界,小说用文字,主题乐园用砖头和表演,电子游戏用代码。今天 AI 生成、推演的数字世界,不过是这条线上最新的一环。
这些「世界」的区别,从来不是高科技还是老东西,只有两个维度——它离真实生活有多近;你是在外面看,还是已经走进去。
拓展阅读与参考来源
定义与思想源头
- World model(Wikipedia):世界模型的通用定义——学习环境动力学、预测未来状态、支持行动规划。
- Kenneth Craik《The Nature of Explanation》(1943)最早提出「心智模型」:思维是对现实的符号化模拟。这是世界模型的思想源头,参见 Kenneth Craik(Wikipedia)。
现代 AI 世界模型
- David Ha, Jürgen Schmidhuber, World Models(2018):用压缩的隐式表征构建世界模型,在「梦境」里训练智能体。论文 · 项目主页(含可交互 Demo)
- Danijar Hafner et al., Dream to Control: Learning Behaviors by Latent Imagination(ICLR 2020,Dreamer 系列开山作):在学到的世界模型里「想象」出策略。论文
- DeepMind, Genie: Generative Interactive Environments(2024):从视频中学习可交互的潜在世界模型。论文
JEPA 与视频世界模型
- Meta 博客 V-JEPA: The next step toward advanced machine intelligence(2024,杨立昆路线官方介绍)。链接
- Adrien Bardes et al., Revisiting Feature Prediction for Learning Visual Representations from Video(V-JEPA 原始论文,联合嵌入预测架构)。论文
- V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning(2025):从视频预测走向规划与机器人控制。论文
- OpenAI, Video generation models as world simulators(2024,Sora 技术报告)。链接
LLM 的隐式世界模型
- Kenneth Li et al., Emergent World Representations: Exploring a Sequence Model Trained on a Synthetic Task(Othello-GPT,ICLR 2023):transformer 在内部编码了棋盘状态。论文
- Wes Gurnee, Max Tegmark, Language Models Represent Space and Time(ICLR 2024):LLM 内部存在空间与时间的表征。论文
- Keyon Vafa et al., Evaluating the World Model Implicit in a Generative Model(NeurIPS 2024):系统检验生成模型隐式学到的世界模型是否真实可用。论文